第一章 基础知识
算法 是一个满足下列条件的计算:
输入:有满足给定约束条件的输入
输出:能够输出满足给定约束条件的结果
有穷性:有限步内必须停止
确定性:每一步都是严格定义和确定的动作
可行性:每一个动作都能够被精确地机械的执行
一般用算法的时间复杂度 来度量算法的效率。
算法在机器上真正运行的时间取决于硬件性能,所以一般用该算法解决某问题所需的基本运算次数 来表示算法的效率,这个次数通常还与问题的规模n n n 输入规模 的函数T ( n ) T(n) T ( n )
最后,相同规模的数据,也可能因为数据特点的不同,导致不同的基本运算次数。通常,算法的时间复杂度分为最坏情况下的时间复杂度 W ( n ) W(n) W ( n ) 平均情况下的时间复杂度 A ( n ) A(n) A ( n )
A ( n ) = ∑ I ∈ S P I t I A(n)=\sum_{I\in S}P_I t_I A ( n ) = ∑ I ∈ S P I t I S S S n n n I ∈ S I\in S I ∈ S P I P_I P I I I I t I t_I t I
设f , g f, g f , g N \N N
若存在正数c , n 0 c, n_0 c , n 0 n ⩾ n 0 n\geqslant n_0 n ⩾ n 0 0 ⩽ f ( n ) ⩽ c ⋅ g ( n ) 0\leqslant f(n)\leqslant c\cdot g(n) 0 ⩽ f ( n ) ⩽ c ⋅ g ( n ) f ( n ) f(n) f ( n ) 渐进的上界 是g ( n ) g(n) g ( n ) f ( n ) = O ( g ( n ) ) f(n)=O(g(n)) f ( n ) = O ( g ( n ))
若存在正数c , n 0 c, n_0 c , n 0 n ⩾ n 0 n\geqslant n_0 n ⩾ n 0 0 ⩽ c ⋅ g ( n ) ⩽ f ( n ) 0\leqslant c\cdot g(n)\leqslant f(n) 0 ⩽ c ⋅ g ( n ) ⩽ f ( n ) f ( n ) f(n) f ( n ) 渐进的下界 是g ( n ) g(n) g ( n ) f ( n ) = Ω ( g ( n ) ) f(n)=\Omega(g(n)) f ( n ) = Ω ( g ( n ))
若对于任意的正数c c c n 0 n_0 n 0 n ⩾ n 0 n\geqslant n_0 n ⩾ n 0 0 ⩽ f ( n ) < c ⋅ g ( n ) 0\leqslant f(n)< c\cdot g(n) 0 ⩽ f ( n ) < c ⋅ g ( n ) f ( n ) = o ( g ( n ) ) f(n)=o(g(n)) f ( n ) = o ( g ( n ))
若对于任意的正数c c c n 0 n_0 n 0 n ⩾ n 0 n\geqslant n_0 n ⩾ n 0 0 ⩽ c ⋅ g ( n ) < f ( n ) 0\leqslant c\cdot g(n)< f(n) 0 ⩽ c ⋅ g ( n ) < f ( n ) f ( n ) = ω ( g ( n ) ) f(n)=\omega (g(n)) f ( n ) = ω ( g ( n ))
若f ( n ) = O ( g ( n ) ) f(n)=O(g(n)) f ( n ) = O ( g ( n )) f ( n ) = Ω ( g ( n ) ) f(n)=\Omega(g(n)) f ( n ) = Ω ( g ( n )) g ( n ) g(n) g ( n ) 渐进的紧的界 ,记为f ( n ) = Θ ( g ( n ) ) f(n)=\Theta(g(n)) f ( n ) = Θ ( g ( n ))
大O O O
O ( f ) + O ( g ) = O ( max ( f , g ) ) O(f)+O(g)=O(\max(f, g)) O ( f ) + O ( g ) = O ( max ( f , g )) O ( f ) + O ( g ) = O ( f + g ) O(f)+O(g)=O(f+g) O ( f ) + O ( g ) = O ( f + g ) O ( f ) O ( g ) = O ( f g ) O(f)O(g)=O(fg) O ( f ) O ( g ) = O ( f g ) O ( c f ( n ) ) = O ( f ( n ) ) O(cf(n))=O(f(n)) O ( c f ( n )) = O ( f ( n )) c > 0 c>0 c > 0 f = O ( f ) f=O(f) f = O ( f ) 如果g ( n ) = O ( f ( n ) ) g(n)=O(f(n)) g ( n ) = O ( f ( n )) O ( f ) + O ( g ) = O ( f ) O(f)+O(g)=O(f) O ( f ) + O ( g ) = O ( f )
设f , g f, g f , g N \N N
如果lim n → ∞ f ( n ) / g ( n ) \lim_{n\rightarrow \infin}f(n)/g(n) lim n → ∞ f ( n ) / g ( n ) c > 0 c>0 c > 0 f ( n ) = Θ ( g ( n ) ) f(n)=\Theta(g(n)) f ( n ) = Θ ( g ( n ))
如果lim n → ∞ f ( n ) / g ( n ) = 0 \lim_{n\rightarrow \infin}f(n)/g(n)=0 lim n → ∞ f ( n ) / g ( n ) = 0 f ( n ) = o ( g ( n ) ) f(n)=o(g(n)) f ( n ) = o ( g ( n ))
如果lim n → ∞ f ( n ) / g ( n ) = + ∞ \lim_{n\rightarrow \infin}f(n)/g(n)=+\infin lim n → ∞ f ( n ) / g ( n ) = + ∞ f ( n ) = ω ( g ( n ) ) f(n)=\omega(g(n)) f ( n ) = ω ( g ( n ))
设函数f , g , h f, g, h f , g , h N \mathbb{N} N
若f = O ( g ) , g = O ( h ) f=O(g), g=O(h) f = O ( g ) , g = O ( h ) f = O ( h ) f=O(h) f = O ( h )
若f = Ω ( g ) , g = Ω ( h ) f=\Omega(g), g=\Omega(h) f = Ω ( g ) , g = Ω ( h ) f = Ω ( h ) f=\Omega(h) f = Ω ( h )
若f = Θ ( g ) , g = Θ ( h ) f=\Theta(g), g=\Theta(h) f = Θ ( g ) , g = Θ ( h ) f = Θ ( h ) f=\Theta(h) f = Θ ( h )
多项式函数:f ( n ) = a 0 + a 1 n + ⋯ + a d n d f(n)=a_0+a_1n+\dots+a_dn^d f ( n ) = a 0 + a 1 n + ⋯ + a d n d a d ≠ 0 a_d\neq 0 a d = 0 f ( n ) = Θ ( n d ) f(n)=\Theta(n^d) f ( n ) = Θ ( n d )
对数函数:对每个b > 1 , α > 0 b>1, \alpha>0 b > 1 , α > 0 log b n = o ( n α ) \log_b n=o(n^\alpha) log b n = o ( n α ) log k n = Θ ( log l n ) \log_k n=\Theta(\log_l n) log k n = Θ ( log l n )
指数函数:对每个r > 1 r>1 r > 1 d > 0 d>0 d > 0 n d = o ( r n ) n^d=o(r^n) n d = o ( r n )
阶乘函数:由Stirling 公式
n ! = 2 π n ( n e ) n ( 1 + Θ ( 1 n ) ) n!=\sqrt{2\pi n}\left(\frac n e\right)^n\left(1+\Theta\left(\frac 1 n\right)\right)
n ! = 2 πn ( e n ) n ( 1 + Θ ( n 1 ) )
可得n ! = o ( n n ) , n ! = ω ( 2 n ) , log ( n ! ) = Θ ( n log n ) n!=o(n^n), n!=\omega(2^n), \log(n!)=\Theta(n\log n) n ! = o ( n n ) , n ! = ω ( 2 n ) , log ( n !) = Θ ( n log n )
调和级数,可以用积分做其渐进的界:
ln ( n + 1 ) = 1 + ∫ 1 n 1 x d x ⩾ 1 + ∑ k = 2 n 1 k = ∑ k = 1 n 1 k ⩾ ∫ 1 n + 1 1 x d x = ln n \ln (n+1)=1+\int_1^n \frac 1 x dx\geqslant 1+\sum_{k=2}^n \frac 1 k=\sum_{k=1}^n\frac 1 k \geqslant \int_{1}^{n+1} \frac 1 x dx=\ln n
ln ( n + 1 ) = 1 + ∫ 1 n x 1 d x ⩾ 1 + k = 2 ∑ n k 1 = k = 1 ∑ n k 1 ⩾ ∫ 1 n + 1 x 1 d x = ln n
所以:
∑ k = 1 n 1 k = Θ ( ln n ) \sum_{k=1}^n\frac 1 k=\Theta(\ln n)
k = 1 ∑ n k 1 = Θ ( ln n )
主定理:设a ⩾ 1 , b > 1 a\geqslant 1, b>1 a ⩾ 1 , b > 1 f ( n ) f(n) f ( n ) T ( n ) T(n) T ( n )
T ( n ) = a T ( n b ) + f ( n ) T(n)=aT(\frac n b)+f(n)
T ( n ) = a T ( b n ) + f ( n )
则:
若f ( n ) = O ( n log b a − ε ) , ε > 0 f(n)=O(n^{\log _ba-\varepsilon}), \varepsilon>0 f ( n ) = O ( n l o g b a − ε ) , ε > 0 T ( n ) = Θ ( n log b a ) T(n)=\Theta(n^{\log_ba}) T ( n ) = Θ ( n l o g b a )
若f ( n ) = Θ ( n log b a ) f(n)=\Theta(n^{\log_ba}) f ( n ) = Θ ( n l o g b a ) T ( n ) = Θ ( n log b a log n ) T(n)=\Theta(n^{\log_b a}\log n) T ( n ) = Θ ( n l o g b a log n )
若f ( n ) = O ( n log b a + ε ) , ε > 0 f(n)=O(n^{\log _ba+\varepsilon}), \varepsilon>0 f ( n ) = O ( n l o g b a + ε ) , ε > 0 c < 1 c<1 c < 1 n n n a f ( n / b ) ⩽ c f ( n ) af(n/b)\leqslant cf(n) a f ( n / b ) ⩽ c f ( n ) T ( n ) = Θ ( f ( n ) ) T(n)=\Theta(f(n)) T ( n ) = Θ ( f ( n ))
第二章 分治算法
1、基本概念
分治算法基本思想是将一个规模为n n n k k k
分(Divide):将大规模问题分割成若干个更小规模的子问题。如果子问题的规模不够小,则再继续划分,如此递归地进行下去。
治(Conquer):解决这些子问题。
合(Combine):将这些子问题的解合并为原问题的解。
其中分这个步骤是分治算法基础和关键,一般要遵循两个原则:
平衡子问题原则:分割出的若干个子问题,其规模最好大致相当
独立子问题原则:分割出的若干个子问题,之间的重叠越少越好,最好是互相独立的
一般地,分治算法时间复杂度可以写为以下递推形式 :
W ( n ) = W ( ∣ P 1 ∣ ) + W ( ∣ P 2 ∣ ) + ⋯ + W ( ∣ P k ∣ ) + f ( n ) W ( c ) = C \begin{align*}
W(n)=W(|P_1|)+W(|P_2|)+\dots+W(|P_k|)+f(n) \\
W(c)=C
\end{align*}
W ( n ) = W ( ∣ P 1 ∣ ) + W ( ∣ P 2 ∣ ) + ⋯ + W ( ∣ P k ∣ ) + f ( n ) W ( c ) = C
其中∣ P i ∣ |P_i| ∣ P i ∣ i i i f ( n ) f(n) f ( n ) C C C c c c
根据分解出的子问题规模,具体还有以下两种常见的递推形式:
T ( n ) = ∑ i = 1 k a i T ( n − i ) + f ( n ) T ( n ) = a T ( n / b ) + d ( n ) \begin{align*}
T(n)=\sum_{i=1}^k a_i T(n-i)+f(n) \\
T(n)=aT(n/b)+d(n)
\end{align*}
T ( n ) = i = 1 ∑ k a i T ( n − i ) + f ( n ) T ( n ) = a T ( n / b ) + d ( n )
例如:
汉诺塔问题T ( n ) = 2 T ( n − 1 ) + 1 T(n)=2T(n-1)+1 T ( n ) = 2 T ( n − 1 ) + 1
二分查找问题T ( n ) = T ( n / 2 ) + 1 T(n)=T(n/2)+1 T ( n ) = T ( n /2 ) + 1
归并排序问题T ( n ) = 2 T ( n / 2 ) + n T(n)=2T(n/2)+n T ( n ) = 2 T ( n /2 ) + n
对于第一个方程,可以用迭代法、递归树、尝试法求解;对于第二个方程,易看出这是主定理的形式。
当d ( n ) d(n) d ( n )
T ( n ) = { Θ ( n log b a ) a ≠ 1 Θ ( log n ) a = 1 T(n)=\begin{cases}
\Theta(n^{\log_ba}) & a\neq 1\\
\Theta(\log n) & a=1
\end{cases}
T ( n ) = { Θ ( n l o g b a ) Θ ( log n ) a = 1 a = 1
当d ( n ) = c n d(n)=cn d ( n ) = c n
T ( n ) = { Θ ( n ) a < b Θ ( n log n ) a = b Θ ( n log b a ) a > b T(n)=\begin{cases}
\Theta(n) & a<b\\
\Theta(n\log n) & a=b\\
\Theta(n^{\log_ba}) & a>b
\end{cases}
T ( n ) = ⎩ ⎨ ⎧ Θ ( n ) Θ ( n log n ) Θ ( n l o g b a ) a < b a = b a > b
2、实例
2.1、逆序对问题
给定一个包含n n n A A A i < j i<j i < j A [ i ] > A [ j ] A[i]>A[j] A [ i ] > A [ j ]
分:当数组规模为n > 2 n>2 n > 2 n / 2 n/2 n /2
治:递归地求解两个子数组的逆序对数量。如果n = 1 n=1 n = 1 n = 2 n=2 n = 2
合:原数组的逆序对数量=两个子数组之间的逆序对数量+跨两个子数组的逆序对数量。
治的时候同时使元素按升序排列,并在并的时候按照升序合并,这样可以使计算跨两个子数组的逆序对的复杂度降为O ( n ) O(n) O ( n )
时间复杂度递推式:
W ( n ) = 2 W ( n / 2 ) + O ( n ) W ( 1 ) = 0 , W ( 2 ) = 1 \begin{align*}
W(n)=2W(n/2)+O(n)\\
W(1)=0, W(2)=1
\end{align*}
W ( n ) = 2 W ( n /2 ) + O ( n ) W ( 1 ) = 0 , W ( 2 ) = 1
所以W ( n ) = O ( n log n ) W(n)=O(n\log n) W ( n ) = O ( n log n )
2.2、芯片测试问题
现有n n n
考虑用其他n − 1 n-1 n − 1 ⌊ n 2 ⌋ + 1 \lfloor\frac{n}{2}\rfloor+1 ⌊ 2 n ⌋ + 1
A 是好的,则至少有⌊ n 2 ⌋ \lfloor\frac{n}{2}\rfloor ⌊ 2 n ⌋
A 是坏的,则至少有⌊ n 2 ⌋ + 1 \lfloor\frac{n}{2}\rfloor+1 ⌊ 2 n ⌋ + 1
另外,两个芯片都报告对方是好时,两个芯片都好或者都坏。
于是可以考虑如下分治策略:
分:当n > 3 n>3 n > 3 n n n n − 1 n-1 n − 1
治:n < = 3 n<=3 n <= 3
合:治的时候,已经得到了
下面证明算法正确性。假设n n n i i i j j j k k k
2 i + 2 j + 2 k = n 2 i + j > 2 k + j \begin{align*}
2i+2j+2k=n\\
2i+j>2k+j
\end{align*}
2 i + 2 j + 2 k = n 2 i + j > 2 k + j
淘汰后,好芯片数量为i i i k k k i > k i>k i > k n n n n n n
最终剩余 3 片以内时:
n = 1 , 2 n=1, 2 n = 1 , 2 n = 3 n=3 n = 3
时间复杂度递推式:
W ( n ) = W ( n / 2 ) + O ( n ) W ( 3 ) = 1 , W ( 2 ) = W ( 1 ) = 0 \begin{align*}
W(n)=W(n/2)+O(n)\\
W(3)=1, W(2)=W(1)=0
\end{align*}
W ( n ) = W ( n /2 ) + O ( n ) W ( 3 ) = 1 , W ( 2 ) = W ( 1 ) = 0
最终有W ( n ) = O ( n ) W(n)=O(n) W ( n ) = O ( n )
2.3、快速排序
给定一个长度为n n n
分:当n n n x x x x x x x x x
治:当n < = 1 n<=1 n <= 1
合:合并 A1、x、A2。由于子数组都是排好序的,[A1, x, A2]就是有序的。
快速排序的时间复杂度与选择的基准元素有关,划分出的两个子数组的规模直接影响了排序效率。
最坏的情况下,每次一个子数组长度满的,另一个子数组空的:
W ( n ) = W ( n − 1 ) + n − 1 W ( 1 ) = W ( 0 ) = 0 \begin{align*}
W(n)=W(n-1)+n-1\\
W(1)=W(0)=0
\end{align*}
W ( n ) = W ( n − 1 ) + n − 1 W ( 1 ) = W ( 0 ) = 0
所以W ( n ) = n ( n − 1 ) / 2 W(n)=n(n-1)/2 W ( n ) = n ( n − 1 ) /2
最好的情况下,每次划分都能均匀划分:
T ( n ) = 2 T ( n / 2 ) + n − 1 T ( 1 ) = T ( 0 ) = 0 \begin{align*}
T(n)=2T(n/2)+n-1\\
T(1)=T(0)=0
\end{align*}
T ( n ) = 2 T ( n /2 ) + n − 1 T ( 1 ) = T ( 0 ) = 0
所以T ( n ) = Θ ( n log n ) T(n)=\Theta(n\log n) T ( n ) = Θ ( n log n )
考虑计算平均时间复杂度。假设每次选择首元素划分后,首元素位于第i i i
T ( n ) = T ( i − 1 ) + T ( n − i ) + n − 1 T(n)=T(i-1)+T(n-i)+n-1
T ( n ) = T ( i − 1 ) + T ( n − i ) + n − 1
首元素处于每个位置的概率都是1 / n 1/n 1/ n
A ( n ) = 1 n ∑ i = 1 n [ T ( i − 1 ) + T ( n − i ) + n − 1 ] A ( 1 ) = A ( 0 ) = 0 \begin{align*}
A(n)=\frac 1 n\sum_{i=1}^n[T(i-1)+T(n-i)+n-1]\\
A(1)=A(0)=0
\end{align*}
A ( n ) = n 1 i = 1 ∑ n [ T ( i − 1 ) + T ( n − i ) + n − 1 ] A ( 1 ) = A ( 0 ) = 0
可算出T ( n ) = Θ ( n log n ) T(n)=\Theta(n\log n) T ( n ) = Θ ( n log n )
2.4、快速幂
给定整数a , b a, b a , b a b a^b a b
分:b > = 2 b>=2 b >= 2 b b b a b / 2 a^{b/2} a b /2 b b b a ( b − 1 ) / 2 a^{(b-1)/2} a ( b − 1 ) /2
治:b = 1 b=1 b = 1 a a a
和:对子问题结果平方,再视b b b a a a
时间复杂度的递推式:
W ( n ) = W ( n / 2 ) + Θ ( 1 ) W ( 1 ) = 0 \begin{align*}
W(n)=W(n/2)+\Theta(1)\\
W(1)=0
\end{align*}
W ( n ) = W ( n /2 ) + Θ ( 1 ) W ( 1 ) = 0
可得W ( n ) = Θ ( log n ) W(n)=\Theta(\log n) W ( n ) = Θ ( log n )
利用相同的思想可以得到快速矩阵幂。例如斐波那契数列的计算可以写成矩阵形式:
[ F n + 2 F n + 1 F n + 1 F n ] = [ F n + 1 F n F n F n − 1 ] [ 1 1 1 0 ] = [ 1 1 1 0 ] n [ 1 1 1 0 ] = [ 1 1 1 0 ] n + 1 \begin{bmatrix}
F_{n+2} & F_{n+1}\\
F_{n+1} & F_n
\end{bmatrix}=\begin{bmatrix}
F_{n+1} & F_n\\
F_n & F_{n-1}
\end{bmatrix}\begin{bmatrix}
1 & 1\\
1 & 0
\end{bmatrix}=\begin{bmatrix}
1 & 1\\
1 & 0
\end{bmatrix}^n\begin{bmatrix}
1 & 1\\
1 & 0
\end{bmatrix}=\begin{bmatrix}
1 & 1\\
1 & 0
\end{bmatrix}^{n+1}
[ F n + 2 F n + 1 F n + 1 F n ] = [ F n + 1 F n F n F n − 1 ] [ 1 1 1 0 ] = [ 1 1 1 0 ] n [ 1 1 1 0 ] = [ 1 1 1 0 ] n + 1
接下来可以用矩阵快速幂的方法计算。
2.5、选择问题
给定一个长度为n n n
直接遍历。最坏的时间复杂度为W ( n ) = n − 1 + n − 2 = n − 3 W(n)=n-1+n-2=n-3 W ( n ) = n − 1 + n − 2 = n − 3
分治算法。两两一组,可以分为⌊ n / 2 ⌋ \lfloor n/2\rfloor ⌊ n /2 ⌋ ⌈ n / 2 ⌉ \lceil n/2\rceil ⌈ n /2 ⌉ ⌊ n / 2 ⌋ + 1 \lfloor n/2\rfloor+1 ⌊ n /2 ⌋ + 1 2 ( ⌈ n / 2 ⌉ − 1 ) 2(\lceil n/2\rceil-1) 2 (⌈ n /2 ⌉ − 1 ) W ( n ) = ⌊ n / 2 ⌋ + 2 ⌈ n / 2 ⌉ − 2 = ⌈ 3 n / 2 ⌉ − 2 W(n)=\lfloor n/2\rfloor+2\lceil n/2\rceil-2=\lceil 3n/2\rceil-2 W ( n ) = ⌊ n /2 ⌋ + 2 ⌈ n /2 ⌉ − 2 = ⌈ 3 n /2 ⌉ − 2
给定一个长度为n n n
直接遍历两次。最坏的时间复杂度为W ( n ) = n − 1 + n − 2 = 2 n − 3 W(n)=n-1+n-2=2n-3 W ( n ) = n − 1 + n − 2 = 2 n − 3
锦标赛算法。每次两两一组比赛,胜者进入下一轮。由于第二大的元素只可能被最大的元素淘汰。所以可以每次做比较时,将被败者元素添加到胜者元素对应的链表上。最后查找最大元素的链表中最大的元素即可。
最大元素能一直进入下一轮,比较⌈ log 2 n ⌉ \lceil \log_2 n\rceil ⌈ log 2 n ⌉ n − 1 n-1 n − 1 ⌈ log 2 n ⌉ − 1 \lceil \log_2 n\rceil-1 ⌈ log 2 n ⌉ − 1 n − 1 n-1 n − 1 n − 1 n-1 n − 1 W ( n ) = ⌈ log 2 n ⌉ − 1 + n − 1 = n + ⌈ log 2 n ⌉ − 2 W(n)=\lceil \log_2 n\rceil-1+n-1=n+\lceil \log_2 n\rceil-2 W ( n ) = ⌈ log 2 n ⌉ − 1 + n − 1 = n + ⌈ log 2 n ⌉ − 2
给定一个长度为n n n
直接排序后查找。时间复杂度为O ( n log n ) O(n\log n) O ( n log n )
分治算法。每次选取一个基准元素m ∗ m^* m ∗
如果选择算法的时间复杂度为T ( n ) T(n) T ( n ) T ( c n ) T(cn) T ( c n ) c < 1 c<1 c < 1 T ( d n ) T(dn) T ( d n ) d > 1 d>1 d > 1 c + d < 1 c+d<1 c + d < 1 O ( n ) O(n) O ( n )
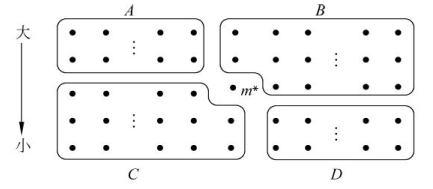
考虑五个元素一组,找到每组的中位数,然后找到所有中位数的中位数,作为基准元素。然后将整个数组按下图分为四块:
每列就是刚才的一组,设其是从大到小排序的,所以组的中位数恰好都在第三行。列之间根据中位数大小排序基准元素就在第三行的中间。显然 C 中元素都比m ∗ m^* m ∗ m ∗ m^* m ∗ m ∗ m^* m ∗
不妨设n n n n / 5 = 2 r + 1 n/5=2r+1 n /5 = 2 r + 1 ∣ A ∣ = ∣ D ∣ = 2 r , ∣ B ∣ = ∣ C ∣ = 3 r + 2 |A|=|D|=2r, |B|=|C|=3r+2 ∣ A ∣ = ∣ D ∣ = 2 r , ∣ B ∣ = ∣ C ∣ = 3 r + 2 ∣ A ∣ + ∣ D ∣ + ∣ C ∣ = 7 r + 2 < 0.7 n |A|+|D|+|C|=7r+2<0.7n ∣ A ∣ + ∣ D ∣ + ∣ C ∣ = 7 r + 2 < 0.7 n
所以最坏情况下的时间复杂度W ( n ) ⩽ W ( n / 5 ) + W ( 7 n / 10 ) + t n W(n)\leqslant W(n/5)+W(7n/10)+tn W ( n ) ⩽ W ( n /5 ) + W ( 7 n /10 ) + t n W ( n ) = O ( n ) W(n)=O(n) W ( n ) = O ( n )
2.6、多项式在 1 的全体2 n 2n 2 n
1 在复数域上开2 n 2n 2 n 2 n 2n 2 n ω i = cos π j n + i sin π j n \omega_i=\cos \frac{\pi j}{n}+i\sin \frac{\pi j}{n} ω i = cos n πj + i sin n πj i = 0 , 1 , … , 2 n − 1 i=0, 1, \dots, 2n-1 i = 0 , 1 , … , 2 n − 1 A ( x ) = a 0 + a 1 x + ⋯ + a n − 1 x n − 1 A(x)=a_0+a_1x+\dots+a_{n-1}x^{n-1} A ( x ) = a 0 + a 1 x + ⋯ + a n − 1 x n − 1 A ( ω i ) A(\omega_i) A ( ω i )
根据定义,一个个的求。求单个A ( ω i ) A(\omega_i) A ( ω i ) O ( n 2 ) O(n^2) O ( n 2 ) O ( n 3 ) O(n^3) O ( n 3 )
迭代法。有迭代式A i ( x ) = a n − i + x A i − 1 ( x ) , A 1 ( x ) = a n − 1 A_i(x)=a_{n-i}+xA_{i-1}(x), A_1(x)=a_{n-1} A i ( x ) = a n − i + x A i − 1 ( x ) , A 1 ( x ) = a n − 1 A n ( x ) = A ( x ) A_n(x)=A(x) A n ( x ) = A ( x ) O ( n ) O(n) O ( n ) O ( n 2 ) O(n^2) O ( n 2 )
分治算法。不妨设n = 2 r n=2r n = 2 r A 0 ( x ) = a 0 + a 2 x + ⋯ + a 2 r x , A 1 ( x ) = a 1 + a 3 x + ⋯ + a 2 r − 1 ( x ) A_0(x)=a_0+a_2 x+\cdots+a_{2r}x, A_1(x)=a_1+a_3 x+\cdots+a_{2r-1}(x) A 0 ( x ) = a 0 + a 2 x + ⋯ + a 2 r x , A 1 ( x ) = a 1 + a 3 x + ⋯ + a 2 r − 1 ( x ) A ( x ) = A 0 ( x 2 ) + x A 1 ( x 2 ) A(x)=A_0(x^2)+xA_1(x^2) A ( x ) = A 0 ( x 2 ) + x A 1 ( x 2 )
有ω i 2 = ω ( 2 i ) % ( 2 n ) \omega_i^2=\omega_{(2i)\%(2n)} ω i 2 = ω ( 2 i ) % ( 2 n ) A ( ω i ) = A 0 ( ω ( 2 i ) % ( 2 n ) ) + ω i A 1 ( ω ( 2 i ) % ( 2 n ) ) , ∀ j A(\omega_i)=A_0(\omega_{(2i)\%(2n)})+\omega_i A_1(\omega_{(2i)\%(2n)}), \forall j A ( ω i ) = A 0 ( ω ( 2 i ) % ( 2 n ) ) + ω i A 1 ( ω ( 2 i ) % ( 2 n ) ) , ∀ j T ( n ) = 2 T ( n / 2 ) + O ( n ) T(n)=2T(n/2)+O(n) T ( n ) = 2 T ( n /2 ) + O ( n ) T ( n ) = O ( n log n ) T(n)=O(n\log n) T ( n ) = O ( n log n )
2.7、平面点集凸包问题
给定一个平面上的点集,找到包含所有点的最小凸多边形。
考虑分治算法。首先找到纵坐标最大和最小的两个点,用它们之间的连线d d d d d d P P P d d d a , b a, b a , b a , b , d a, b, d a , b , d
初始划分的时间复杂度为O ( n ) O(n) O ( n ) d d d P P P O ( n ) O(n) O ( n ) O ( n ) O(n) O ( n ) n − 1 n-1 n − 1 W ( n ) = W ( n − 1 ) + O ( n ) W(n)=W(n-1)+O(n) W ( n ) = W ( n − 1 ) + O ( n ) W ( n ) = O ( n 2 ) W(n)=O(n^2) W ( n ) = O ( n 2 ) O ( n 2 ) O(n^2) O ( n 2 )
3、分治算法的改进
3.1、减少子问题个数
考虑分治算法时间复杂度递推式:
W ( n ) = a W ( n / b ) + d ( n ) W(n)=aW(n/b)+d(n)
W ( n ) = aW ( n / b ) + d ( n )
当a > b a>b a > b d ( n ) d(n) d ( n ) W ( n ) = Θ ( n log b a ) W(n)=\Theta(n^{\log_ba}) W ( n ) = Θ ( n l o g b a ) a a a W ( n ) W(n) W ( n )
利用子问题之间的依赖关系,使得某些子问题的解可以通过组合其他子问题的解得到。这样,可以减少子问题的个数,降低时间复杂度。
考虑两个n n n X , Y X, Y X , Y O ( n 2 ) O(n^2) O ( n 2 )
将每个数分为两部分X = X 1 ⋅ 2 n / 2 + X 0 , Y = Y 1 ⋅ 2 n / 2 + Y 0 X=X_1\cdot 2^{n/2}+X_0, Y=Y_1\cdot 2^{n/2}+Y_0 X = X 1 ⋅ 2 n /2 + X 0 , Y = Y 1 ⋅ 2 n /2 + Y 0
X ⋅ Y = ( X 1 ⋅ 2 n / 2 + X 0 ) ( Y 1 ⋅ 2 n / 2 + Y 0 ) = X 1 Y 1 ⋅ 2 n + ( X 1 Y 0 + X 0 Y 1 ) ⋅ 2 n / 2 + X 0 Y 0 X\cdot Y=(X_1\cdot 2^{n/2}+X_0)(Y_1\cdot 2^{n/2}+Y_0)=X_1Y_1\cdot 2^n+(X_1Y_0+X_0Y_1)\cdot 2^{n/2}+X_0Y_0
X ⋅ Y = ( X 1 ⋅ 2 n /2 + X 0 ) ( Y 1 ⋅ 2 n /2 + Y 0 ) = X 1 Y 1 ⋅ 2 n + ( X 1 Y 0 + X 0 Y 1 ) ⋅ 2 n /2 + X 0 Y 0
时间复杂度W ( n ) = 4 W ( n / 2 ) + O ( n ) W(n)=4W(n/2)+O(n) W ( n ) = 4 W ( n /2 ) + O ( n ) W ( n ) = O ( n log 2 4 ) = O ( n 2 ) W(n)=O(n^{\log_2 4})=O(n^2) W ( n ) = O ( n l o g 2 4 ) = O ( n 2 )
寻找子问题之间的依赖关系,可以发现:
X 1 Y 0 + X 0 Y 1 = ( X 1 + X 0 ) ( Y 1 + Y 0 ) − X 1 Y 1 − X 0 Y 0 X_1Y_0+X_0Y_1=(X_1+X_0)(Y_1+Y_0)-X_1Y_1-X_0Y_0
X 1 Y 0 + X 0 Y 1 = ( X 1 + X 0 ) ( Y 1 + Y 0 ) − X 1 Y 1 − X 0 Y 0
所以仅需要三次乘法运算,就可以得到X ⋅ Y X\cdot Y X ⋅ Y W ( n ) = 3 W ( n / 2 ) + O ( n ) W(n)=3W(n/2)+O(n) W ( n ) = 3 W ( n /2 ) + O ( n ) W ( n ) = O ( n log 2 3 ) = O ( n 1.59 ) W(n)=O(n^{\log_2 3})=O(n^{1.59}) W ( n ) = O ( n l o g 2 3 ) = O ( n 1.59 )
Strassen 矩阵乘法,也用了类似的思想。将两个矩阵相乘,考虑将每个矩阵分为四个子矩阵,可以得到:
[ A 11 A 12 A 21 A 22 ] [ B 11 B 12 B 21 B 22 ] = [ C 11 C 12 C 21 C 22 ] \begin{bmatrix}
A_{11} & A_{12}\\
A_{21} & A_{22}
\end{bmatrix}\begin{bmatrix}
B_{11} & B_{12}\\
B_{21} & B_{22}
\end{bmatrix}= \begin{bmatrix}
C_{11} & C_{12}\\
C_{21} & C_{22}
\end{bmatrix}
[ A 11 A 21 A 12 A 22 ] [ B 11 B 21 B 12 B 22 ] = [ C 11 C 21 C 12 C 22 ]
如果只是普通的分块计算:
C 11 = A 11 B 11 + A 12 B 21 C 12 = A 11 B 12 + A 12 B 22 C 21 = A 21 B 11 + A 22 B 21 C 22 = A 21 B 12 + A 22 B 22 \begin{align*}
C_{11}=A_{11}B_{11}+A_{12}B_{21}\\
C_{12}=A_{11}B_{12}+A_{12}B_{22}\\
C_{21}=A_{21}B_{11}+A_{22}B_{21}\\
C_{22}=A_{21}B_{12}+A_{22}B_{22}
\end{align*}
C 11 = A 11 B 11 + A 12 B 21 C 12 = A 11 B 12 + A 12 B 22 C 21 = A 21 B 11 + A 22 B 21 C 22 = A 21 B 12 + A 22 B 22
时间复杂度为W ( n ) = 8 W ( n / 2 ) + O ( n 2 ) W(n)=8W(n/2)+O(n^2) W ( n ) = 8 W ( n /2 ) + O ( n 2 ) W ( n ) = O ( n 3 ) W(n)=O(n^3) W ( n ) = O ( n 3 )
考虑这样计算:
M 1 = A 11 ( B 12 − B 22 ) M 2 = ( A 11 + A 12 ) B 22 M 3 = ( A 21 + A 22 ) B 11 M 4 = A 22 ( B 21 − B 11 ) M 5 = ( A 11 + A 22 ) ( B 11 + B 22 ) M 6 = ( A 12 − A 22 ) ( B 21 + B 22 ) M 7 = ( A 11 − A 21 ) ( B 11 + B 12 ) \begin{align*}
M_1=A_{11}(B_{12}-B_{22})\\
M_2=(A_{11}+A_{12})B_{22}\\
M_3=(A_{21}+A_{22})B_{11}\\
M_4=A_{22}(B_{21}-B_{11})\\
M_5=(A_{11}+A_{22})(B_{11}+B_{22})\\
M_6=(A_{12}-A_{22})(B_{21}+B_{22})\\
M_7=(A_{11}-A_{21})(B_{11}+B_{12})
\end{align*}
M 1 = A 11 ( B 12 − B 22 ) M 2 = ( A 11 + A 12 ) B 22 M 3 = ( A 21 + A 22 ) B 11 M 4 = A 22 ( B 21 − B 11 ) M 5 = ( A 11 + A 22 ) ( B 11 + B 22 ) M 6 = ( A 12 − A 22 ) ( B 21 + B 22 ) M 7 = ( A 11 − A 21 ) ( B 11 + B 12 )
则:
C 11 = M 5 + M 4 − M 2 + M 6 C 12 = M 1 + M 2 C 21 = M 3 + M 4 C 22 = M 5 + M 1 − M 3 − M 7 \begin{align*}
C_{11}=M_5+M_4-M_2+M_6\\
C_{12}=M_1+M_2\\
C_{21}=M_3+M_4\\
C_{22}=M_5+M_1-M_3-M_7
\end{align*}
C 11 = M 5 + M 4 − M 2 + M 6 C 12 = M 1 + M 2 C 21 = M 3 + M 4 C 22 = M 5 + M 1 − M 3 − M 7
所以时间复杂度为W ( n ) = 7 W ( n / 2 ) + O ( n 2 ) W(n)=7W(n/2)+O(n^2) W ( n ) = 7 W ( n /2 ) + O ( n 2 ) W ( n ) = O ( n log 2 7 ) = O ( n 2.81 ) W(n)=O(n^{\log_2 7})=O(n^{2.81}) W ( n ) = O ( n l o g 2 7 ) = O ( n 2.81 )
目前最好的算法是 Coppersmith-Winograd 算法,时间复杂度为O ( n 2.376 ) O(n^{2.376}) O ( n 2.376 )
3.2、增加预处理
用平面最邻近点对问题说明:给定一个平面点集,找到之间距离最短的一对点。
朴素方法,两两枚举。共有C n 2 C_n^2 C n 2 O ( n 2 ) O(n^2) O ( n 2 )
分治方法,将点集分为两部分,分别求解,然后考虑跨两部分的最邻近点对,一共三部分。
分割考虑做中垂线(也即按照 x 坐标分割),分为大小相近的两部分。一开始按 x 坐标进行排序O ( n log n ) O(n\log n) O ( n log n ) O ( n ) O(n) O ( n ) O ( n log n ) O(n\log n) O ( n log n )
对于找跨两部分的点对,设两部分中最邻近点对的距离分别是δ 0 , δ 1 \delta_0, \delta_1 δ 0 , δ 1 δ = min ( δ 0 , δ 1 ) \delta=\min(\delta_0, \delta_1) δ = min ( δ 0 , δ 1 ) δ \delta δ ( x 1 , y 1 ) (x_1, y_1) ( x 1 , y 1 ) δ \delta δ [ y 1 − δ , y 1 + δ ] [y_1-\delta, y_1+\delta] [ y 1 − δ , y 1 + δ ] ( x 1 , y 1 ) (x_1, y_1) ( x 1 , y 1 ) O ( n ) O(n) O ( n ) O ( n ) O(n) O ( n ) O ( 1 ) O(1) O ( 1 ) O ( n log n ) O(n\log n) O ( n log n )
所以总的时间复杂度递推式为W ( n ) = 2 W ( n / 2 ) + O ( n log n ) W(n)=2W(n/2)+O(n\log n) W ( n ) = 2 W ( n /2 ) + O ( n log n ) W ( n ) = O ( n log 2 n ) W(n)=O(n\log^2 n) W ( n ) = O ( n log 2 n )
上面的分治方法中,每次递归都要调用一次排序(对 y 进行排序),这是因为分割的时候是对 x 进行排序,不能保证顶点数组中 y 的坐标也是有序的。有没有可能,分割的时候,同时能得到 x 的有序性和 y 的有序性,且还能够正常将每个点的 x 和 y 对应起来?
考虑预处理,一开始按 y 也进行排序,不过要带上额外信息,用于确定其属于那个点。
用 C++数据结构来说明:一开始有顶点坐标数组vector<pair<float, float>> points。创建pair<float, int> x,其中第一个元素是某个顶点的 x 坐标,第二个元素是顶点 ID(可以取在原顶点数组中的下标)。然后按 x 坐标排序,得到有序的vector<pair<float, int>>。再创建pair<float, int>,其中第一个元素是 y 坐标,第二个元素是顶点 ID 。按 y 坐标排序,得到有序的vector<pair<float, int>>。
然后进行分割。可以在O ( n ) O(n) O ( n ) vector<pair<float, int>> x_1, x_2。根据顶点 ID,扫描vector<pair<float, int>> y,顶点 ID 相同,说明是同一个点的 y 坐标,划分到对应的部分。可以在O ( n ) O(n) O ( n ) vector<pair<float, int>> y_1, y_2,且仍然是有序的。
这样时间复杂度递推式为W ( n ) = 2 W ( n / 2 ) + O ( n ) W(n)=2W(n/2)+O(n) W ( n ) = 2 W ( n /2 ) + O ( n ) W ( n ) = O ( n log n ) W(n)=O(n\log n) W ( n ) = O ( n log n )
第三章 动态规划
1、基本概念
多阶段决策问题 是指,求解的问题求解的问题可以划分为一系列相互联系的阶段,在每个阶段都需要作出决策,且一个阶段决策的选择会影响下一个阶段的决策,从而影响整个过程的活动路线,求解的目标是选择各个阶段的决策使整个过程达到最优。
动态规划 (Dynamic Programming)就是一种在研究多阶段决策问题时提出的一种解方法,其基本思想是把多阶段过程转化为一系列单阶段问题,然后逐个求解。动态规划常常用于求解以时间划分阶段的动态过程的优化问题,对于一些与时间无关的静态规划,也可以以人为引入时间因素,然后同样适用动态规划地方法求解。
阶段:利用动态规划求解问题,需要将问题恰当地划分为若干个相互联系 的阶段
状态:每个阶段开始时,问题或者系统所处的客观状况。状态既是某个阶段的某个 起点,也是前一个阶段的某个 终点,一个阶段可以有若干种可能的状态。
策略:每个阶段都需要作出决策,决策使得系统从一个状态转移到另一个状态。各个阶段的决策构成一个决策序列,这个序列就称之为一个策略。从某个阶段开始到终止阶段的过程称为一个子过程 ,对应的策略称为一个子策略 。
状态的无后效性 是指,某个阶段的状态给定之后,则该阶段之后的过程的发展不受该阶段以前各段状态的影响,也就是说状态具有马尔可夫性 。适用于动态规划求解的问题,其中各个状态必须具有无后效性。
动态规划的实质是分治+减少冗余计算。
动态规划也是将原问题分解为若干个子问题,先求解子问题,然后根据子问题的解得到原问题的解。
与分治不同的是,动态规划中子问题往往不是相互独立的,会出现相同的子问题。如果使用分治方法求解,会有很多重复计算。动态规划用一个表来保存子问题的解,自底向上计算,最终求出原问题的解。
利用动态规划求解问题的一般步骤:
找出最优解的性质,并刻画其结构特征
递归地定义最优值,也即写出动态规划方程(状态转移方程)
自底向上计算最优值
根据计算最优值时得到的信息,构造最优解(可选)
2、Bellman 最优性原理
如果某个问题的最优策略的子策略总是最优的,则称该问题满足 Bellman 最优性原理。对于满足 Bellman 最优性原理的问题,如果其某个策略的子策略不是最优的,则该策略也不是最优的。
有向带权图G G G v i v_i v i v j v_j v j
证:假设该问题不满足最优性原理,则存在一条v i v_i v i v j v_j v j v i → u → w → v j v_i\rightarrow u \rightarrow w \rightarrow v_j v i → u → w → v j u → w → v j u \rightarrow w\rightarrow v_j u → w → v j u u u v j v_j v j
假设u u u v j v_j v j u → w ′ → v j u\rightarrow w'\rightarrow v_j u → w ′ → v j v i → u → w ′ → v j v_i\rightarrow u \rightarrow w' \rightarrow v_j v i → u → w ′ → v j
由反证法可知,从顶点v i v_i v i v j v_j v j
无向无权图G G G q q q t t t G G G q ↔ r ↔ s ↔ t ↔ q q\leftrightarrow r \leftrightarrow s \leftrightarrow t \leftrightarrow q q ↔ r ↔ s ↔ t ↔ q
q q q t t t q → r → t q\rightarrow r\rightarrow t q → r → t q q q r r r q → s → t → r q\rightarrow s\rightarrow t\rightarrow r q → s → t → r r r r t t t r → q → s → t r\rightarrow q\rightarrow s\rightarrow t r → q → s → t
动态规划方法对问题的有效性,取决于问题本身是否满足:
最优子结构 :也称为优化原则 ,是指一个最优决策序列的任何子序列本身一定是相对于子序列初始和结束状态最优的决策序列。重叠子问题:递归求解时,会需要反复求解相同的子问题。动态规划方法会将子问题的解保存在一个表中,能够避免重复计算。
动态规划算法设计的要点:
问题要求什么?约束条件是什么?
如何划分子问题?
原问题的最优值与子问题的最优值之间的关系是什么?(状态转移方程)
是否满足最优子结构?
最小的子问题是什么?其解如何计算?(边界条件)
3、实例
3.1、多起点多终点的最短路径问题
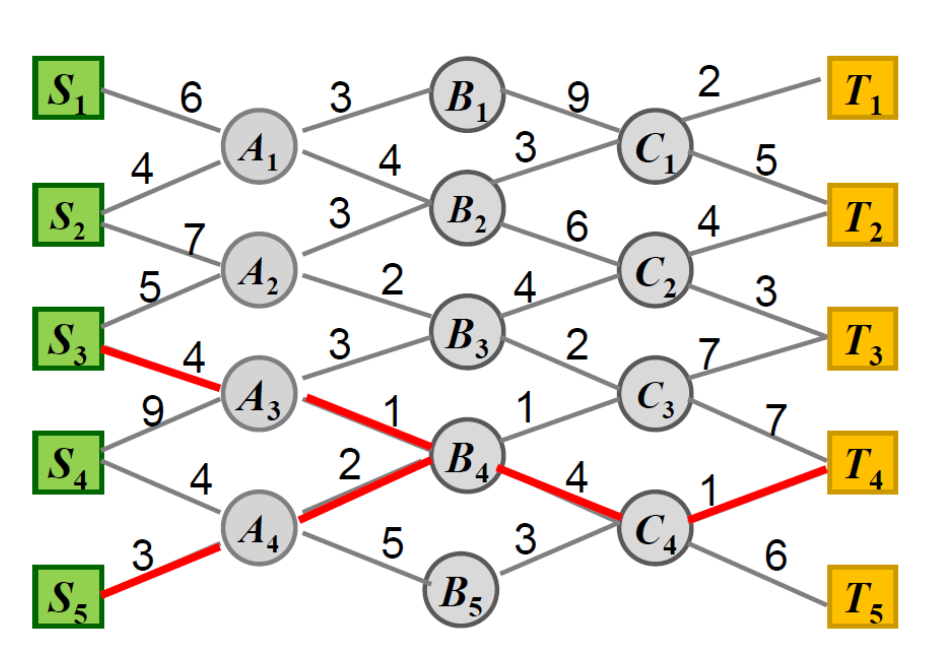
给定一个有向带权图G G G { S 1 , S 2 , … , S n } \{S_1, S_2, \dots, S_n\} { S 1 , S 2 , … , S n } { T 1 , T 2 , … , T m } \{T_1, T_2, \dots, T_m\} { T 1 , T 2 , … , T m }
蛮力算法,穷举每一条可能的路径。假定起点到终点的(平均)要经过k k k O ( n 2 k ) O(n2^k) O ( n 2 k )
动态规划算法,考虑从终点开始,逐步前推。先求出起点集为{ C i } \{C_i\} { C i } { T j } \{T_j\} { T j } F ( C i ) = min j { C i T j } F(C_i)=\min_{j}\{C_iT_j\} F ( C i ) = min j { C i T j } { B k } \{B_k\} { B k } { T j } \{T_j\} { T j } F ( B k ) = min j { B k C j + F ( C j ) } F(B_k)=\min_{j}\{B_kC_j+F(C_j)\} F ( B k ) = min j { B k C j + F ( C j )} F ( S l ) = min m { S l A m + F ( A m ) } F(S_l)=\min_{m}\{S_lA_m+F(A_m)\} F ( S l ) = min m { S l A m + F ( A m )} F ( S l ) F(S_l) F ( S l )
能使用动态规划算法,是因为满足最优子结构。即全局最短路径的子路径,也一定是相对这个子路径起点和终点的最短路径。
3.2、矩阵链相乘
给定矩阵序列A 1 , A 2 , … , A n \boldsymbol{A}_1, \boldsymbol{A}_2, \dots, \boldsymbol{A}_n A 1 , A 2 , … , A n A i \boldsymbol{A}_i A i P i − 1 × P i P_{i-1}\times P_i P i − 1 × P i
蛮力算法,考虑穷举每一种可能的加括号方式。加完括号的序列可以写成一个二叉树,树的每个叶子节点都对应一个矩阵,每个子树对应着一个一对括号。由叶子节点开始,逐步向上计算,最终得到根节点对应的矩阵。根节点矩阵就对应着答案,整个过程就对应着计算的过程。
设n n n x n x_n x n
x n + 1 = ∑ i = 1 n x i x n + 1 − i , x 1 = 1 , x 2 = 1 x_{n+1}=\sum_{i=1}^n x_i x_{n+1-i}, x_1=1, x_2=1
x n + 1 = i = 1 ∑ n x i x n + 1 − i , x 1 = 1 , x 2 = 1
也即i i i n + 1 − i n+1-i n + 1 − i n + 1 n+1 n + 1 卡特兰数 (Catalan Number)的定义本质上相同:
C n = ∑ i = 0 n − 1 C i C n − 1 − i , C 0 = 1 , C 1 = 1 C_{n}=\sum_{i=0}^{n-1}C_{i}C_{n-1-i}, C_0=1, C_1=1
C n = i = 0 ∑ n − 1 C i C n − 1 − i , C 0 = 1 , C 1 = 1
也即有x n + 1 = C n x_{n+1}=C_n x n + 1 = C n
所以对于长度为n + 1 n+1 n + 1 C n C_n C n
W ( n ) = Ω ( C n ) = Ω ( 1 n + 1 ( 2 n ) ! n ! n ! ) = Ω ( 4 n n 3 / 2 ) W(n)=\Omega(C_n)=\Omega(\frac{1}{n+1}\frac{(2n)!}{n!n!})=\Omega\left(\frac{4^n}{n^{3/2}}\right)
W ( n ) = Ω ( C n ) = Ω ( n + 1 1 n ! n ! ( 2 n )! ) = Ω ( n 3/2 4 n )
这是一个指数级别的时间复杂度。
动态规划算法。考虑某个矩阵链A i A i + 1 … A j \boldsymbol{A}_i\boldsymbol{A}_{i+1}\dots\boldsymbol{A}_j A i A i + 1 … A j m [ i , j ] m[i, j] m [ i , j ] k k k A i A i + 1 … A k \boldsymbol{A}_i\boldsymbol{A}_{i+1}\dots\boldsymbol{A}_k A i A i + 1 … A k A k + 1 A k + 2 … A j \boldsymbol{A}_{k+1}\boldsymbol{A}_{k+2}\dots\boldsymbol{A}_j A k + 1 A k + 2 … A j
m [ i , k ] + m [ k + 1 , j ] + P i − 1 P k P j m[i, k]+m[k+1, j]+P_{i-1}P_kP_j
m [ i , k ] + m [ k + 1 , j ] + P i − 1 P k P j
所以每一个问题,可以遍历最后一次乘法出现的位置,写出递推式如下:
m [ i , j ] = { 0 , i = j min i ⩽ k < j { m [ i , k ] + m [ k + 1 , j ] + P i − 1 P k P j } , i < j m[i, j]=\begin{cases}
0, & i=j\\
\min_{i\leqslant k<j}\{m[i, k]+m[k+1, j]+P_{i-1}P_kP_j\}, & i<j
\end{cases}
m [ i , j ] = { 0 , min i ⩽ k < j { m [ i , k ] + m [ k + 1 , j ] + P i − 1 P k P j } , i = j i < j
该问题是满足最优子结构的。
利用数学归纳法,如果不做任何其他处理,可以证明上面动态规划方法的时间复杂度T ( n ) ⩾ 2 n − 1 T(n)\geqslant 2^{n-1} T ( n ) ⩾ 2 n − 1
这是因为,每次遇到m [ i , j ] m[i, j] m [ i , j ]
追踪解时,只需记录下每次最终选取的k k k
记忆化之后,时间复杂度降低到O ( n 3 ) O(n^3) O ( n 3 )
3.3、投资问题
有m m m n n n f i ( x ) f_i(x) f i ( x ) x x x i i i
记F k ( x ) F_k(x) F k ( x ) x x x k k k k − 1 k-1 k − 1 k k k
F k ( x ) = max 0 ⩽ y ⩽ x { F k − 1 ( x − y ) + f k ( y ) } F_k(x)=\max_{0\leqslant y\leqslant x}\{F_{k-1}(x-y)+f_k(y)\}
F k ( x ) = 0 ⩽ y ⩽ x max { F k − 1 ( x − y ) + f k ( y )}
时间复杂度为O ( n m 2 ) O(nm^2) O ( n m 2 )
3.4、一般背包问题
假设将n n n i i i w i w_i w i v i v_i v i b b b
记只考虑前k k k y y y F k ( y ) F_k(y) F k ( y ) k k k
F k ( y ) = max { F k − 1 ( y ) , F k ( y − w k ) + v k } F_k(y)=\max\{F_{k-1}(y), F_{k}(y-w_k)+v_k\}
F k ( y ) = max { F k − 1 ( y ) , F k ( y − w k ) + v k }
追踪解,只需同时记录一个i k ( y ) i_k(y) i k ( y ) F k ( y ) F_k(y) F k ( y )
i k ( y ) = { i k − 1 ( y ) , F k − 1 ( y ) > F k ( y − w k ) + v k k , F k − 1 ( y ) ⩽ F k ( y − w k ) + v k i_k(y)=\begin{cases}
i_{k-1}(y), & F_{k-1}(y)> F_k(y-w_k)+v_k\\
k, & F_{k-1}(y)\leqslant F_k(y-w_k)+v_k
\end{cases}
i k ( y ) = { i k − 1 ( y ) , k , F k − 1 ( y ) > F k ( y − w k ) + v k F k − 1 ( y ) ⩽ F k ( y − w k ) + v k
F n ( b ) F_n(b) F n ( b ) x = i n ( b ) x=i_n(b) x = i n ( b ) i n ( b − w x ) i_n(b-w_x) i n ( b − w x )
时间复杂度为O ( n b ) O(nb) O ( nb )
3.5、最长公共子序列问题
设两个序列X = { x 1 , x 2 , … , x m } X=\{x_1, x_2, \dots, x_m\} X = { x 1 , x 2 , … , x m } Z = { z 1 , z 2 , … , z n } Z=\{z_1, z_2, \dots, z_n\} Z = { z 1 , z 2 , … , z n } j 1 < j 2 < ⋯ < j n j_1<j_2<\dots<j_n j 1 < j 2 < ⋯ < j n z i = x j i , ∀ i = 1 , 2 , … , n z_i=x_{j_i}, \forall i=1, 2, \dots, n z i = x j i , ∀ i = 1 , 2 , … , n Z Z Z X X X Z Z Z X X X Y Y Y X X X Y Y Y
给定两个序列X X X Y Y Y
蛮力算法。依次检查X X X Y Y Y 2 ∣ X ∣ 2^{|X|} 2 ∣ X ∣ ∣ Y ∣ |Y| ∣ Y ∣ m = ∣ X ∣ ⩽ ∣ Y ∣ = n m=|X|\leqslant |Y|=n m = ∣ X ∣ ⩽ ∣ Y ∣ = n O ( n 2 m ) O(n 2^m) O ( n 2 m )
动态规划算法。记考虑X X X i i i Y Y Y j j j C [ i , j ] C[i, j] C [ i , j ] x i = y j x_i=y_j x i = y j
C [ i , j ] = { C [ i − 1 , j − 1 ] + 1 , x i = y j max { C [ i − 1 , j ] , C [ i , j − 1 ] } , x i ≠ x j C[i, j]=\begin{cases}
C[i-1, j-1]+1, & x_i=y_j\\
\max\{C[i-1, j], C[i, j-1]\}, & x_i\neq x_j
\end{cases}
C [ i , j ] = { C [ i − 1 , j − 1 ] + 1 , max { C [ i − 1 , j ] , C [ i , j − 1 ]} , x i = y j x i = x j
追踪解,根据上面三种情况反向追踪即可。
总的时间复杂度为O ( m n ) O(mn) O ( mn )
3.6、黑白图像存储问题
设图像像素序列为{ p 1 , p 2 , … , p n } \{p_1, p_2, \dots, p_n\} { p 1 , p 2 , … , p n } p i p_i p i
考虑对像素点序列进行分段S 1 , S 2 , … , S m S_1, S_2, \dots, S_m S 1 , S 2 , … , S m S i S_i S i l [ i ] l[i] l [ i ] l [ i ] − 1 ⩽ 255 l[i]-1\leqslant 255 l [ i ] − 1 ⩽ 255 b [ i ] b[i] b [ i ] ( l [ i ] b [ i ] + 8 + 3 ) ⋅ m (l[i]b[i]+8+3)\cdot m ( l [ i ] b [ i ] + 8 + 3 ) ⋅ m b i b_i b i
b [ i ] = ⌈ log 2 ( max p j ∈ S i p j + 1 ) ⌉ b[i]=\left\lceil\log_2\left(\max_{p_j\in S_i}p_j+1\right)\right\rceil
b [ i ] = ⌈ log 2 ( p j ∈ S i max p j + 1 ) ⌉
求出最佳分段方案,使得总的存储位数最少。
动态规划算法。记S [ i ] S[i] S [ i ] i i i S m S_m S m
S [ i ] = min 1 ⩽ j ⩽ min { i , 256 } { S [ i − j ] + j ⋅ b [ m ] + 11 } , b m = ⌈ log 2 ( max p j ∈ S m p j + 1 ) ⌉ S[i]=\min_{1\leqslant j\leqslant \min\{i, 256\}}\{S[i-j]+j\cdot b[m]+11\}, b_m=\left\lceil\log_2\left(\max_{p_j\in S_m}p_j+1\right)\right\rceil
S [ i ] = 1 ⩽ j ⩽ m i n { i , 256 } min { S [ i − j ] + j ⋅ b [ m ] + 11 } , b m = ⌈ log 2 ( p j ∈ S m max p j + 1 ) ⌉
追踪解只需要记录每次最终选择的j j j
总的时间复杂度为O ( n ) O(n) O ( n )
3.7、最大子串和问题
给定n n n A = { a 1 , a 2 , … , a n } A=\{a_1, a_2, \dots, a_n\} A = { a 1 , a 2 , … , a n }
蛮力算法。暴力枚举每一个子串,使用前缀和数组的情况下,时间复杂度为O ( n 2 ) O(n^2) O ( n 2 )
分治算法。考虑前半段中的最大子串和以及后半段的最大子串和,以及跨越两个段的最大子串和。跨越两个段的情况,可以从中间往两边拓展,可在O ( n ) O(n) O ( n )
所以时间复杂度T ( n ) = 2 T ( n / 2 ) + O ( n ) T(n)=2T(n/2)+O(n) T ( n ) = 2 T ( n /2 ) + O ( n ) T ( n ) = O ( n log n ) T(n)=O(n\log n) T ( n ) = O ( n log n )
动态规划算法。记S [ i ] S[i] S [ i ] a i a_i a i
S [ i ] = max { S [ i − 1 ] + a i , a i } S[i]=\max\{S[i-1]+a_i, a_i\}
S [ i ] = max { S [ i − 1 ] + a i , a i }
时间复杂度为O ( n ) O(n) O ( n )
3.8、最优二叉搜索树问题
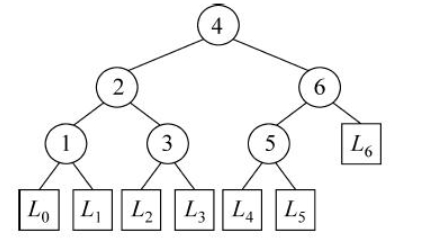
假设有形如下图的二叉搜索树:
其中圆形节点表示是实际数据,方形节点是虚拟节点,是不在二叉搜索树中的数据最终落在的位置。每个节点都有一个概率,表示是搜索中最终节点的概率。
设实际数据集为{ x 1 , x 2 , … , x n } \{x_1, x_2, \dots, x_n\} { x 1 , x 2 , … , x n }
动态规划算法。考虑某段数据{ x i , x i + 1 , … , x j } \{x_i, x_{i+1}, \dots, x_j\} { x i , x i + 1 , … , x j } x k x_k x k m [ i , j ] m[i, j] m [ i , j ] w [ i , j ] w[i, j] w [ i , j ]
m [ i , j ] = min i ⩽ k ⩽ j { m [ i , k − 1 ] + 1 ⋅ w [ i , k − 1 ] + m [ k + 1 , j ] + 1 ⋅ w [ k + 1 , j ] + 1 ⋅ p k } m[i, j]=\min_{i\leqslant k\leqslant j}\{m[i, k-1]+1\cdot w[i, k-1] + m[k+1, j]+1\cdot w[k+1, j] + 1\cdot p_k\}
m [ i , j ] = i ⩽ k ⩽ j min { m [ i , k − 1 ] + 1 ⋅ w [ i , k − 1 ] + m [ k + 1 , j ] + 1 ⋅ w [ k + 1 , j ] + 1 ⋅ p k }
化简后,有:
m [ i , j ] = min i ⩽ k ⩽ j { m [ i , k − 1 ] + m [ k + 1 , j ] + w [ i , j ] } m[i, j]=\min_{i\leqslant k\leqslant j}\{m[i, k-1]+m[k+1, j]+w[i, j]\}
m [ i , j ] = i ⩽ k ⩽ j min { m [ i , k − 1 ] + m [ k + 1 , j ] + w [ i , j ]}
总的时间复杂度为O ( n 3 ) O(n^3) O ( n 3 )
第四章 贪心算法
1、基本概念
贪心法的基本思想是:在对问题求解时,总是做出在当前看来是最好的选择。也即,不从整体最优上加以考虑,只做局部最优解。显然,这样做并不一定能得到全局最优解。
贪心选择性质 是指,一个问题的整体最优解可以通过一系列局部最优的选择得到。要想使用贪心算法得到最优解,必须证明问题具有贪心选择性质。
之前已经提到了最优子结构,一个问题拥有最优子结构是能够用动态规划算法以及贪心算法求解的关键特征。并不是所有具有最优子结构的问题都能够使用贪心算法求解,但是往往可以利用其来证明贪心选择性质。
2、数学归纳法
证明贪心选择性质时,常常用到数学归纳法。数学归纳法适合证明涉及自然数的命题P ( n ) P(n) P ( n )
2.1、第一数学归纳法
归纳基础:证明P ( 1 ) P(1) P ( 1 ) P ( 0 ) P(0) P ( 0 ) k k k P ( k ) P(k) P ( k ) P ( k + 1 ) P(k+1) P ( k + 1 )
2.2、第二数学归纳法
归纳基础:证明P ( 1 ) , P ( 2 ) , … , P ( m ) P(1), P(2), \dots, P(m) P ( 1 ) , P ( 2 ) , … , P ( m ) k k k P ( 1 ) , P ( 2 ) , … , P ( k ) P(1), P(2), \dots, P(k) P ( 1 ) , P ( 2 ) , … , P ( k ) P ( k + 1 ) P(k+1) P ( k + 1 )
3、实例
3.1、活动选择问题
设有n n n i i i s i s_i s i f i f_i f i i i i j j j s i ⩾ f j s_i \geqslant f_j s i ⩾ f j s j ⩾ f i s_j \geqslant f_i s j ⩾ f i i i i j j j
贪心策略 1:总是选择开始最早的活动。这样的话,如果某个活动持续非常久,会挤占掉其他活动,可能不如选稍晚一些开始,但很快结束的活动。
贪心策略 2:总是选持续时间最短的活动。这样的话,如果持续时间最短的活动开始的很晚,可能会错过很多活动。
贪心策略 3:总是选择结束时间最早的活动。先按照结束时间排序,然后扫描一遍,选出相容的活动。时间主要消耗在排序上,复杂度为O ( n log n ) O(n\log n) O ( n log n )
接下来证明贪心选择性质,下面的贪心策略代指贪心策略 3。假设活动集已按照结束时间升序排列,下面提及的序号都是排序后的序号。
命题:按照贪心策略已经选择了k k k i 1 = 1 , i 2 , … , i k i_1=1, i_2, \dots, i_k i 1 = 1 , i 2 , … , i k A A A i 1 = 1 , i 2 , … , i k i_1=1, i_2, \dots, i_k i 1 = 1 , i 2 , … , i k
归纳基础:证明k = 1 k=1 k = 1 i 1 = 1 i_1=1 i 1 = 1 i 1 = 1 i_1=1 i 1 = 1 A A A f 1 ⩽ f j f_1\leqslant f_j f 1 ⩽ f j j j j A ′ A' A ′
归纳步骤:假设对于k k k A A A i 1 = 1 , i 2 , … , i k i_1=1, i_2, \dots, i_k i 1 = 1 , i 2 , … , i k A A A B B B S ′ = { i ∣ i ∈ S , s i ⩾ f i k } S'=\{i| i\in S, s_i \geqslant f_{i_k}\} S ′ = { i ∣ i ∈ S , s i ⩾ f i k } B B B S ′ S' S ′ S ′ S' S ′ S ′ S' S ′ B ′ B' B ′ S ′ S' S ′ { i 1 , i 2 , … , i k } ∪ B ′ = { i 1 , i 2 , … , i k , i k + 1 } ∪ ( B ′ − { i k + 1 ) } ) \{i_1, i_2, \dots, i_k\}\cup B'=\{i_1, i_2, \dots, i_k, i_{k+1}\} \cup (B'-\{i_{k+1})\}) { i 1 , i 2 , … , i k } ∪ B ′ = { i 1 , i 2 , … , i k , i k + 1 } ∪ ( B ′ − { i k + 1 )}) i 1 , i 2 , … , i k , i k + 1 i_1, i_2, \dots, i_k, i_{k+1} i 1 , i 2 , … , i k , i k + 1 k + 1 k+1 k + 1
第六章 线性规划
1、基本概念
1.1、一般形式
线性规划问题的一般形式如下:
min ( max ) z = ∑ j = 1 n c j x j s.t. ∑ j = 1 n a i j x j ⩽ ( = , ⩾ ) b i , i = 1 , 2 , … , m x j ⩾ 0 , j ∈ J ⊆ { 1 , 2 , … , n } x j , j ∈ { 1 , 2 , … , n } − J \begin{align*}
\min(\max) z=\sum_{j=1}^n c_jx_j\\
\text{s.t.} \sum_{j=1}^n a_{ij}x_j \leqslant(=, \geqslant)b_i, & i=1, 2, \dots, m\\
x_j\geqslant 0,& j\in J\subseteq \{1, 2, \dots, n\}\\
x_j, &j\in \{1, 2, \dots, n\}-J
\end{align*}
min ( max ) z = j = 1 ∑ n c j x j s.t. j = 1 ∑ n a ij x j ⩽ ( = , ⩾ ) b i , x j ⩾ 0 , x j , i = 1 , 2 , … , m j ∈ J ⊆ { 1 , 2 , … , n } j ∈ { 1 , 2 , … , n } − J
这四行从上到下依次代表:目标函数 ,约束条件 ,非负约束条件 ,自由变量 。
可行解 :满足约束条件和非负条件的变量可行域 :所有可行解的集合最优解 :在可行域中,目标函数取得最小(或最大)值的解最优值 :最优解对应的目标函数值
在高中已经学习过了二维线性规划的图解法,可行域由多条代表约束条件的直线围城,是一个凸多边形(可能无界,也可能是空集)。如果有最优解,一定在凸多边形的顶点取到。解的情况有四种:
有唯一最优解
有无穷多个最优解
有可行解,但无最优解
无可行解,也无最优解
推广到一般的n n n
1.2、标准形
一般线性规划问题,总是可以写成标准形:
min z = ∑ j = 1 n c j x j s.t. ∑ j = 1 n a i j x j = b i , i = 1 , 2 , … , m x j ⩾ 0 , j = 1 , 2 , … , n \begin{align*}
\min z=\sum_{j=1}^n c_jx_j\\
\text{s.t.} \sum_{j=1}^n a_{ij}x_j=b_i, & i=1, 2, \dots, m\\
x_j\geqslant 0,& j=1, 2, \dots, n
\end{align*}
min z = j = 1 ∑ n c j x j s.t. j = 1 ∑ n a ij x j = b i , x j ⩾ 0 , i = 1 , 2 , … , m j = 1 , 2 , … , n
将max \max max min \min min
∑ j = 1 n a i j x j ⩽ b i ⇒ ∑ j = 1 n a i j x j + y i = b i , y i ⩾ 0 ∑ j = 1 n a i j x j ⩾ b i ⇒ ∑ j = 1 n a i j x j − y i = b i , y i ⩾ 0 \begin{align*}
\sum_{j=1}^n a_{ij}x_j\leqslant b_i \Rightarrow \sum_{j=1}^n a_{ij}x_j+y_i=b_i, y_i\geqslant 0 \\
\sum_{j=1}^n a_{ij}x_j\geqslant b_i \Rightarrow \sum_{j=1}^n a_{ij}x_j-y_i=b_i, y_i\geqslant 0
\end{align*}
j = 1 ∑ n a ij x j ⩽ b i ⇒ j = 1 ∑ n a ij x j + y i = b i , y i ⩾ 0 j = 1 ∑ n a ij x j ⩾ b i ⇒ j = 1 ∑ n a ij x j − y i = b i , y i ⩾ 0
其中第一行引入的变量称为松弛变量 ,第二行引入的变量称为剩余变量 。
对于自由变量:
x j ∈ R ⇒ x j = x j ′ − x j ′ ′ , x j ′ ⩾ 0 , x j ′ ′ ⩾ 0 x_j\in R\Rightarrow x_j=x_j'-x_j'', x_j'\geqslant 0, x_j''\geqslant 0
x j ∈ R ⇒ x j = x j ′ − x j ′′ , x j ′ ⩾ 0 , x j ′′ ⩾ 0
1.3、矩阵形式
标准形可以写为矩阵形式。其中目标函数可写为:
min z = c T x = [ c 1 c 2 ⋮ c n ] T [ x 1 x 2 ⋮ x n ] \min z=\boldsymbol{c}^T\boldsymbol{x}=\begin{bmatrix}
c_1 \\
c_2 \\
\vdots \\
c_n
\end{bmatrix}^T \begin{bmatrix}
x_1\\
x_2\\
\vdots\\
x_n
\end{bmatrix}
min z = c T x = c 1 c 2 ⋮ c n T x 1 x 2 ⋮ x n
约束条件可写为:
[ a 11 a 12 … a 1 n a 21 a 22 … a 2 n ⋮ ⋮ ⋱ ⋮ a m 1 a m 2 … a m n ] [ x 1 x 2 ⋮ x n ] = [ P 1 P 2 … P n ] [ x 1 x 2 ⋮ x n ] = A x = b \begin{bmatrix}
a_{11} & a_{12} & \dots & a_{1n} \\
a_{21} & a_{22} & \dots & a_{2n} \\
\vdots & \vdots & \ddots & \vdots \\
a_{m1} & a_{m2} & \dots & a_{mn}
\end{bmatrix} \begin{bmatrix}
x_1\\
x_2\\
\vdots\\
x_n
\end{bmatrix}=\begin{bmatrix}
\boldsymbol{P}_1 & \boldsymbol{P}_2 & \dots & \boldsymbol{P}_n
\end{bmatrix} \begin{bmatrix}
x_1\\
x_2\\
\vdots\\
x_n
\end{bmatrix}=\boldsymbol{A}\boldsymbol{x}=\boldsymbol{b}
a 11 a 21 ⋮ a m 1 a 12 a 22 ⋮ a m 2 … … ⋱ … a 1 n a 2 n ⋮ a mn x 1 x 2 ⋮ x n = [ P 1 P 2 … P n ] x 1 x 2 ⋮ x n = A x = b
2、标准形的解
2.1、一些定义
设A \boldsymbol{A} A r r r A \boldsymbol{A} A m m m 基 。
给定标准形的一组基B = { P i 1 , P i 2 , … , P i m } \boldsymbol{B}=\{\boldsymbol{P}_{i_1}, \boldsymbol{P}_{i_2}, \dots, \boldsymbol{P}_{i_m}\} B = { P i 1 , P i 2 , … , P i m } x i 1 , x i 2 , … , x i m x_{i_1}, x_{i_2}, \dots, x_{i_m} x i 1 , x i 2 , … , x i m 基变量 ,其余变量称为非基变量 。
基变量构成的向量记为x B \boldsymbol{x}_B x B x N \boldsymbol{x}_N x N x N = 0 \boldsymbol{x}_N=\boldsymbol{0} x N = 0 B x B = b \boldsymbol{B}\boldsymbol{x}_B=\boldsymbol{b} B x B = b x B = B − 1 b \boldsymbol{x}_B=\boldsymbol{B}^{-1}\boldsymbol{b} x B = B − 1 b x B \boldsymbol{x}_B x B x N \boldsymbol{x}_N x N x \boldsymbol{x} x x \boldsymbol{x} x B \boldsymbol{B} B 基本解 (系数矩阵满秩,所以基本解是唯一的)。如果x \boldsymbol{x} x x i ⩾ 0 , ∀ i x_i\geqslant 0, \forall i x i ⩾ 0 , ∀ i 基本可行解 ,对应的基称为一个可行基 。
2.2、基本可行解的性质
引理 :A x = b \boldsymbol{Ax}=\boldsymbol{b} Ax = b α \boldsymbol{\alpha} α α \boldsymbol{\alpha} α
必要性,由基本解的定义立得。
充分性,设α \boldsymbol{\alpha} α P j 1 , P j 2 , … , P j r \boldsymbol{P}_{j_1}, \boldsymbol{P}_{j_2}, \dots, \boldsymbol{P}_{j_r} P j 1 , P j 2 , … , P j r A \boldsymbol{A} A m m m m − r m-r m − r P j r + 1 , P j r + 2 , … , P j m \boldsymbol{P}_{j_{r+1}}, \boldsymbol{P}_{j_{r+2}}, \dots, \boldsymbol{P}_{j_m} P j r + 1 , P j r + 2 , … , P j m m m m A \boldsymbol{A} A B \boldsymbol{B} B α \boldsymbol{\alpha} α B x B = b \boldsymbol{B}\boldsymbol{x}_B=\boldsymbol{b} B x B = b α \boldsymbol{\alpha} α
定理 1 :若标准形有可行解,则必有基本可行解。
证明:设α \boldsymbol{\alpha} α α 1 , α 2 , … , α r \alpha_1, \alpha_2, \dots, \alpha_r α 1 , α 2 , … , α r P j 1 , P j 2 , … , P j r \boldsymbol{P}_{j_1}, \boldsymbol{P}_{j_2}, \dots, \boldsymbol{P}_{j_r} P j 1 , P j 2 , … , P j r r r r α \boldsymbol{\alpha} α
若不然,由线性无关,存在不全为 0 的λ 1 , λ 2 , … , λ r \lambda_1, \lambda_2, \dots, \lambda_r λ 1 , λ 2 , … , λ r ∑ i = 1 r λ i P j i = 0 \sum_{i=1}^r \lambda_i\boldsymbol{P}_{j_i}=\boldsymbol{0} ∑ i = 1 r λ i P j i = 0 λ r + 1 = λ r + 2 = ⋯ = λ n = 0 \lambda_{r+1}=\lambda_{r+2}=\dots=\lambda_n=0 λ r + 1 = λ r + 2 = ⋯ = λ n = 0 ∑ i = 1 n λ i P j i = 0 \sum_{i=1}^n \lambda_i\boldsymbol{P}_{j_i}=\boldsymbol{0} ∑ i = 1 n λ i P j i = 0 δ \delta δ
∑ i = 1 n ( α i + δ λ i ) P j i = ∑ i = 1 n α i P j i + δ ∑ i = 1 n λ i P j i = b \sum_{i=1}^n (\alpha_i+\delta \lambda_i)\boldsymbol{P}_{j_i}=\sum_{i=1}^n \alpha_i\boldsymbol{P}_{j_i}+\delta\sum_{i=1}^n \lambda_i\boldsymbol{P}_{j_i}=\boldsymbol{b}
i = 1 ∑ n ( α i + δ λ i ) P j i = i = 1 ∑ n α i P j i + δ i = 1 ∑ n λ i P j i = b
如果想让α + δ λ \boldsymbol{\alpha}+\delta \boldsymbol{\lambda} α + δ λ α i + δ λ i ⩾ 0 , ∀ i \alpha_i+\delta \lambda_i\geqslant 0, \forall i α i + δ λ i ⩾ 0 , ∀ i
λ i = 0 \lambda_i=0 λ i = 0 λ i > 0 \lambda_i>0 λ i > 0 δ ⩾ − α i λ i \delta \geqslant -\frac{\alpha_i}{\lambda_i} δ ⩾ − λ i α i λ j < 0 \lambda_j<0 λ j < 0 δ ⩽ − α i λ i \delta \leqslant -\frac{\alpha_i}{\lambda_i} δ ⩽ − λ i α i k = arg min i , λ i ≠ 0 { ∣ α i λ i ∣ } k=\arg\min_{i, \lambda_i\neq 0}\{|\frac{\alpha_i}{\lambda_i}|\} k = arg min i , λ i = 0 { ∣ λ i α i ∣ } δ ∗ = − α k λ k \delta^*= -\frac{\alpha_k}{\lambda_k} δ ∗ = − λ k α k β = α + δ ∗ λ \boldsymbol{\beta}=\boldsymbol{\alpha}+\delta^*\boldsymbol{\lambda} β = α + δ ∗ λ α \boldsymbol{\alpha} α 少一个非零分量 (α k + δ ∗ λ k = 0 \alpha_k+\delta^*\lambda_k=0 α k + δ ∗ λ k = 0 r r r
综上,证毕。
定理 2 :若标准形有最优解,则必定存在一个基本可行解是最优解。
证明:只需在定理 1 的基础上,证明α \boldsymbol{\alpha} α β \boldsymbol{\beta} β
设α \boldsymbol{\alpha} α α i \alpha_i α i λ i = 0 \lambda_i=0 λ i = 0 δ \delta δ α i ± δ λ i ⩾ 0 \alpha_i\pm \delta \lambda_i\geqslant 0 α i ± δ λ i ⩾ 0 α i \alpha_i α i λ i ≠ 0 \lambda_i\neq 0 λ i = 0 δ > 0 \delta>0 δ > 0 α i ± δ λ i ⩾ 0 \alpha_i\pm \delta \lambda_i\geqslant 0 α i ± δ λ i ⩾ 0 α ± δ λ \boldsymbol{\alpha}\pm\delta \boldsymbol{\lambda} α ± δ λ α \boldsymbol{\alpha} α
∑ i = 1 n c i α i ⩽ ∑ i = 1 n c i ( α i ± δ λ i ) = ∑ i = 1 n c i α i ± δ ∑ i = 1 n c i λ i \sum_{i=1}^n c_i\alpha_i\leqslant \sum_{i=1}^n c_i(\alpha_i\pm \delta \lambda_i)=\sum_{i=1}^n c_i\alpha_i\pm \delta \sum_{i=1}^n c_i\lambda_i
i = 1 ∑ n c i α i ⩽ i = 1 ∑ n c i ( α i ± δ λ i ) = i = 1 ∑ n c i α i ± δ i = 1 ∑ n c i λ i
可得∑ i = 1 n c i λ i = 0 \sum_{i=1}^n c_i\lambda_i=0 ∑ i = 1 n c i λ i = 0
∑ i = 1 n c i β i = ∑ i = 1 n c i ( α i + δ ∗ λ i ) = ∑ i = 1 n c i α i \sum_{i=1}^n c_i\beta_i=\sum_{i=1}^n c_i(\alpha_i+ \delta^* \lambda_i)=\sum_{i=1}^n c_i\alpha_i
i = 1 ∑ n c i β i = i = 1 ∑ n c i ( α i + δ ∗ λ i ) = i = 1 ∑ n c i α i
所以β \boldsymbol{\beta} β
综上,要找到原问题的一个最优解,在标准形中的基本可行解中寻找即可。A \boldsymbol{A} A C n m C_{n}^{m} C n m C n m C_{n}^{m} C n m
3、单纯形法
基本步骤如下:
选取一个初始可行基,确定初始基本可行解
检查当前的基本可行解。若是最优解或发现无最优解,则结束;否则作基变换 ,用一个非基变量替换一个基变量,得到新的基和对应的基本可行解,且使目标函数值至少不增。
3.1、确定初始基本可行解
考虑最简单的情况,设约束条件为:
∑ j = 1 n a i j x j ⩽ 0 , i = 1 , 2 , … , m \sum_{j=1}^n a_{ij}x_j \leqslant 0, i=1, 2, \dots, m
j = 1 ∑ n a ij x j ⩽ 0 , i = 1 , 2 , … , m
其中b i ⩾ 0 b_i\geqslant 0 b i ⩾ 0 m m m x n + i ⩾ 0 x_{n+i}\geqslant 0 x n + i ⩾ 0
∑ j = 1 n a i j x j + x n + i = 0 , i = 1 , 2 , … , m \sum_{j=1}^n a_{ij}x_j +x_{n+i}=0, i=1, 2, \dots, m
j = 1 ∑ n a ij x j + x n + i = 0 , i = 1 , 2 , … , m
选取{ x n + i } \{x_{n+i}\} { x n + i } ( 0 , 0 , … , 0 , b 1 , b 2 , … , b m ) T (0, 0, \dots, 0, b_1, b_2, \dots, b_m)^T ( 0 , 0 , … , 0 , b 1 , b 2 , … , b m ) T
3.2、最优性检验
考虑某个可行基B = ( P π ( 1 ) , P π ( 2 ) , ⋯ , P π ( m ) ) \boldsymbol{B}=(\boldsymbol{P}_{\pi (1)}, \boldsymbol{P}_{\pi (2)}, \cdots, \boldsymbol{P}_{\pi (m)}) B = ( P π ( 1 ) , P π ( 2 ) , ⋯ , P π ( m ) ) π ( ⋅ ) \pi(\cdot) π ( ⋅ ) B \boldsymbol{B} B i i i A \boldsymbol{A} A π ( i ) \pi(i) π ( i ) A \boldsymbol{A} A N \boldsymbol{N} N
B − 1 A x = B − 1 ( B x B + N x N ) = x B + B − 1 N x N = B − 1 b \boldsymbol{B}^{-1}\boldsymbol{A}\boldsymbol{x}=\boldsymbol{B}^{-1}(\boldsymbol{B}\boldsymbol{x}_B+\boldsymbol{N}\boldsymbol{x}_N)=\boldsymbol{x}_B+\boldsymbol{B}^{-1}\boldsymbol{N}\boldsymbol{x}_N=\boldsymbol{B}^{-1}\boldsymbol{b}
B − 1 A x = B − 1 ( B x B + N x N ) = x B + B − 1 N x N = B − 1 b
可解得x B = B − 1 b − B − 1 N x N \boldsymbol{x}_B=\boldsymbol{B}^{-1}\boldsymbol{b}-\boldsymbol{B}^{-1}\boldsymbol{N}\boldsymbol{x}_N x B = B − 1 b − B − 1 N x N
代入目标函数:
z = c T x = c B T x B + c N T x N = c B T B − 1 b + ( c N T − c B T B − 1 N ) x N z=\boldsymbol{c}^T\boldsymbol{x}=\boldsymbol{c}_B^T\boldsymbol{x}_B+\boldsymbol{c}_N^T\boldsymbol{x}_N=\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{b}+(\boldsymbol{c}_N^T-\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{N})\boldsymbol{x}_N
z = c T x = c B T x B + c N T x N = c B T B − 1 b + ( c N T − c B T B − 1 N ) x N
所以,对于基B \boldsymbol{B} B x \boldsymbol{x} x x B = B − 1 b \boldsymbol{x}_B=\boldsymbol{B}^{-1}\boldsymbol{b} x B = B − 1 b x N = 0 \boldsymbol{x}_N=\boldsymbol{0} x N = 0 z 0 = c B T B − 1 b z_0=\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{b} z 0 = c B T B − 1 b
将z 0 z_0 z 0 简化的目标函数 :
z = z 0 + ( c N T − c B T B − 1 N ) x N = z 0 + ( c B T − c B T B − 1 B ) x B + ( c N T − c B T B − 1 N ) x N = z 0 + ( c T − c B T B − 1 A ) x = z 0 + λ T x \begin{align*}
z&=z_0+(\boldsymbol{c}_N^T-\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{N})\boldsymbol{x}_N=z_0+(\boldsymbol{c}_B^T-\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{B})\boldsymbol{x}_B+(\boldsymbol{c}_N^T-\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{N})\boldsymbol{x}_N \\
&=z_0+(\boldsymbol{c}^T-\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{A})\boldsymbol{x}=z_0+\boldsymbol{\lambda}^T\boldsymbol{x}
\end{align*}
z = z 0 + ( c N T − c B T B − 1 N ) x N = z 0 + ( c B T − c B T B − 1 B ) x B + ( c N T − c B T B − 1 N ) x N = z 0 + ( c T − c B T B − 1 A ) x = z 0 + λ T x
其中λ T = c T − c B T B − 1 A \boldsymbol{\lambda}^T=\boldsymbol{c}^T-\boldsymbol{c}_B^T\boldsymbol{B}^{-1}\boldsymbol{A} λ T = c T − c B T B − 1 A
称λ \boldsymbol{\lambda} λ λ 1 , λ 2 , … , λ n \lambda_1, \lambda_2, \dots, \lambda_n λ 1 , λ 2 , … , λ n 检验数 ,对应基变量的检验数必为 0。
记B − 1 A = α \boldsymbol{B}^{-1}\boldsymbol{A}=\boldsymbol{\alpha} B − 1 A = α β = B − 1 b \boldsymbol{\beta}= \boldsymbol{B}^{-1}\boldsymbol{b} β = B − 1 b P j ′ = B − 1 P j = ( α 1 j , α 2 j , … , α m j ) T \boldsymbol{P}_j'=\boldsymbol{B}^{-1}\boldsymbol{P}_j=(\alpha_{1j}, \alpha_{2j}, \dots, \alpha_{mj})^T P j ′ = B − 1 P j = ( α 1 j , α 2 j , … , α mj ) T
定理 3 :对于可行基B \boldsymbol{B} B x ( 0 ) \boldsymbol{x}^{(0)} x ( 0 ) λ i ⩾ 0 , ∀ i \lambda_i\geqslant 0, \forall i λ i ⩾ 0 , ∀ i x ( 0 ) \boldsymbol{x}^{(0)} x ( 0 ) λ k < 0 \lambda_k<0 λ k < 0 α i k ⩽ 0 \alpha_{ik}\leqslant 0 α ik ⩽ 0
证明:如果λ i ⩾ 0 , ∀ i \lambda_i \geqslant 0, \forall i λ i ⩾ 0 , ∀ i x \boldsymbol{x} x λ T x ⩾ 0 \boldsymbol{\lambda}^T\boldsymbol{x}\geqslant 0 λ T x ⩾ 0 z ⩾ z 0 z\geqslant z_0 z ⩾ z 0 x ( 0 ) \boldsymbol{x}^{(0)} x ( 0 )
如果存在λ k < 0 \lambda_k<0 λ k < 0 λ \boldsymbol{\lambda} λ λ k \lambda_k λ k x k = M > 0 x_k=M>0 x k = M > 0 x B i = β i − α i k M ⩾ 0 x_{Bi}=\beta_i-\alpha_{ik}M\geqslant 0 x B i = β i − α ik M ⩾ 0 z = z 0 + λ k M + C z=z_0+\lambda_k M+C z = z 0 + λ k M + C C C C C ⩾ 0 C\geqslant 0 C ⩾ 0 M → + ∞ M\to +\infty M → + ∞ z → − ∞ z\to -\infty z → − ∞
还有一种可能的情况是,存在λ k < 0 \lambda_k<0 λ k < 0 α i k \alpha_{ik} α ik
3.3、基变换
设λ k < 0 \lambda_k<0 λ k < 0 α l k > 0 \alpha_{lk}>0 α l k > 0 x k x_k x k x k x_k x k x π ( l ) x_{\pi (l)} x π ( l ) B ′ = { P π ( 1 ) , … , P π ( l − 1 ) , P k , P π ( l + 1 ) , … , P π ( m ) } \boldsymbol{B}'=\{\boldsymbol{P}_{\pi (1)}, \dots, \boldsymbol{P}_{\pi (l-1)}, \boldsymbol{P}_k, \boldsymbol{P}_{\pi (l+1)}, \dots, \boldsymbol{P}_{\pi (m)}\} B ′ = { P π ( 1 ) , … , P π ( l − 1 ) , P k , P π ( l + 1 ) , … , P π ( m ) } x k \boldsymbol{x}_k x k 换入变量 ,x π ( l ) \boldsymbol{x}_{\pi (l)} x π ( l ) 换出变量 。
首先要证明B ′ \boldsymbol{B}' B ′ P π ( l ) \boldsymbol{P}_{\pi (l)} P π ( l ) B ′ \boldsymbol{B}' B ′ B \boldsymbol{B} B P π ( l ) \boldsymbol{P}_{\pi (l)} P π ( l ) B ′ \boldsymbol{B}' B ′ B ′ \boldsymbol{B}' B ′
由于( P π ( 1 ) ′ , P π ( 2 ) ′ , … , P π ( m ) ′ ) = B − 1 B = I (\boldsymbol{P}_{\pi (1)}', \boldsymbol{P}_{\pi (2)}', \dots, \boldsymbol{P}_{\pi (m)}')=\boldsymbol{B}^{-1}\boldsymbol{B}=\boldsymbol{I} ( P π ( 1 ) ′ , P π ( 2 ) ′ , … , P π ( m ) ′ ) = B − 1 B = I P k ′ = ∑ i = 1 m α i k P π ( i ) ′ \boldsymbol{P}_k'=\sum_{i=1}^m \alpha_{ik}\boldsymbol{P}_{\pi (i)}' P k ′ = ∑ i = 1 m α ik P π ( i ) ′ B \boldsymbol{B} B
P π ( l ) = 1 α l k P k − ∑ i ≠ l α i k α l k P π ( i ) \boldsymbol{P}_{\pi (l)}=\frac{1}{\alpha_{lk}}\boldsymbol{P}_k-\sum_{i\neq l}\frac{\alpha_{ik}}{\alpha_{lk}}\boldsymbol{P}_{\pi (i)}
P π ( l ) = α l k 1 P k − i = l ∑ α l k α ik P π ( i )
因此,B ′ \boldsymbol{B}' B ′
由( P π ( 1 ) ′ , P π ( 2 ) ′ , … , P π ( m ) ′ ) = B − 1 B = I (\boldsymbol{P}_{\pi (1)}', \boldsymbol{P}_{\pi (2)}', \dots, \boldsymbol{P}_{\pi (m)}')=\boldsymbol{B}^{-1}\boldsymbol{B}=\boldsymbol{I} ( P π ( 1 ) ′ , P π ( 2 ) ′ , … , P π ( m ) ′ ) = B − 1 B = I i i i P k ′ \boldsymbol{P}_k' P k ′ H \boldsymbol{H} H B \boldsymbol{B} B B ′ \boldsymbol{B}' B ′ B ′ = B H \boldsymbol{B}'=\boldsymbol{B}\boldsymbol{H} B ′ = B H
B ′ − 1 A x = B ′ − 1 b ⇔ H − 1 B − 1 A x = H − 1 B − 1 b = H − 1 β \boldsymbol{B}'^{-1}\boldsymbol{A}\boldsymbol{x}=\boldsymbol{B}'^{-1}b\Leftrightarrow \boldsymbol{H}^{-1}\boldsymbol{B}^{-1}\boldsymbol{A}\boldsymbol{x}=\boldsymbol{H}^{-1}\boldsymbol{B}^{-1}b=\boldsymbol{H}^{-1}\boldsymbol{\beta}
B ′ − 1 A x = B ′ − 1 b ⇔ H − 1 B − 1 A x = H − 1 B − 1 b = H − 1 β
所以用B ′ \boldsymbol{B}' B ′ B \boldsymbol{B} B H − 1 \boldsymbol{H}^{-1} H − 1 H − 1 \boldsymbol{H}^{-1} H − 1
H − 1 = [ 1 − α 1 k / α l k ⋱ ⋮ 1 − α l − 1 , k / α l k 1 / α l k − α l + 1 , k / α l k 1 ⋮ ⋱ − α m k / α l k 1 ] \boldsymbol{H}^{-1}=\begin{bmatrix}
1 & \ & \ & -\alpha_{1k}/\alpha_{lk} & \ & \ & \ \\
\ & \ddots & \ &\vdots & \ & \ \\
\ & \ & 1 & -\alpha_{l-1,k}/\alpha_{lk} & \ & \ \\
\ & \ & \ & 1/\alpha_{lk} & \ & \ \\
\ & \ & \ & -\alpha_{l+1,k}/\alpha_{lk} & 1 & \ \\
\ & \ & \ & \vdots & \ & \ddots \\
\ & \ & \ & -\alpha_{mk}/\alpha_{lk} & \ & \ & 1
\end{bmatrix}
H − 1 = 1 ⋱ 1 − α 1 k / α l k ⋮ − α l − 1 , k / α l k 1/ α l k − α l + 1 , k / α l k ⋮ − α mk / α l k 1 ⋱ 1
记H − 1 B − 1 A = [ α i j ′ ] m × n \boldsymbol{H}^{-1}\boldsymbol{B}^{-1}\boldsymbol{A}=\begin{bmatrix} \alpha'_{ij} \end{bmatrix}_{m\times n} H − 1 B − 1 A = [ α ij ′ ] m × n β ′ = H − 1 B − 1 b \boldsymbol{\beta}'= \boldsymbol{H}^{-1}\boldsymbol{B}^{-1}\boldsymbol{b} β ′ = H − 1 B − 1 b
于是可以写出α i j ′ \alpha'_{ij} α ij ′ β i ′ \beta_i' β i ′
α i j ′ = { α l j α l k , i = l α i j − α i k α l j α l k , i ≠ l \alpha'_{ij}=\begin{cases}
\frac{\alpha_{lj}}{\alpha_{lk}} , & i=l \\
\alpha_{ij}-\frac{\alpha_{ik}\alpha_{lj}}{\alpha_{lk}} , & i\neq l
\end{cases}
α ij ′ = { α l k α l j , α ij − α l k α ik α l j , i = l i = l
β i ′ = { β l α l k , i = l β i − α i k β l α l k , i ≠ l \beta_i'=\begin{cases}
\frac{\beta_l}{\alpha_{lk}} , & i=l \\
\beta_i-\frac{\alpha_{ik}\beta_l}{\alpha_{lk}} , & i\neq l
\end{cases}
β i ′ = { α l k β l , β i − α l k α ik β l , i = l i = l
直观理解,就是把变形后的约束方程x B + B − 1 N x N = B − 1 b \boldsymbol{x}_B+\boldsymbol{B}^{-1}\boldsymbol{N}\boldsymbol{x}_N=\boldsymbol{B}^{-1}\boldsymbol{b} x B + B − 1 N x N = B − 1 b l l l x l x_l x l x l x_l x l
要保证B ′ \boldsymbol{B}' B ′ β i ′ ⩾ 0 , ∀ i \beta_i'\geqslant 0, \forall i β i ′ ⩾ 0 , ∀ i β i ⩾ 0 , ∀ i \beta_i\geqslant 0, \forall i β i ⩾ 0 , ∀ i α l k > 0 \alpha_{lk}>0 α l k > 0 α i k ⩽ 0 \alpha_{ik}\leqslant 0 α ik ⩽ 0 β i ′ ⩾ 0 \beta_i'\geqslant 0 β i ′ ⩾ 0 α l k > 0 \alpha_{lk}>0 α l k > 0
β l α l k ⩽ β i α i k \frac{\beta_l}{\alpha_{lk}}\leqslant \frac{\beta_i}{\alpha_{ik}}
α l k β l ⩽ α ik β i
因此,只需取l = arg min i , α i k > 0 { β i / α i k } l=\arg\min_{i, \alpha_{ik}>0}\{ \beta_i/\alpha_{ik}\} l = arg min i , α ik > 0 { β i / α ik }
相应的,对化简的目标函数也做类似的变换,得到基于B ′ \boldsymbol{B}' B ′
λ j ′ = λ j − λ k α l j α l k z 0 ′ = z 0 + λ k β l α l k \begin{align*}
\lambda_j'&=\lambda_j-\frac{\lambda_k\alpha_{lj}}{\alpha_{lk}}\\
z_0'&=z_0+\frac{\lambda_k\beta_l}{\alpha_{lk}}
\end{align*}
λ j ′ z 0 ′ = λ j − α l k λ k α l j = z 0 + α l k λ k β l
直观上理解,用之前提到的化简后的第l l l z = z 0 + λ T x z=z_0+\boldsymbol{\lambda}^T\boldsymbol{x} z = z 0 + λ T x x k x_k x k
3.4、单纯形法的完整叙述
设初始可行基B = ( P π ( 1 ) , P π ( 2 ) , ⋯ , P π ( m ) ) \boldsymbol{B}=(\boldsymbol{P}_{\pi (1)}, \boldsymbol{P}_{\pi (2)}, \cdots, \boldsymbol{P}_{\pi (m)}) B = ( P π ( 1 ) , P π ( 2 ) , ⋯ , P π ( m ) ) α = B − 1 A \boldsymbol{\alpha}= \boldsymbol{B}^{-1}\boldsymbol{A} α = B − 1 A β = B − 1 b \boldsymbol{\beta}= \boldsymbol{B}^{-1}\boldsymbol{b} β = B − 1 b λ T = c T − c B T α \boldsymbol{\lambda}^T=\boldsymbol{c}^T-\boldsymbol{c}_B^T\boldsymbol{\alpha} λ T = c T − c B T α z 0 = c B T β z_0=\boldsymbol{c}_B^T\boldsymbol{\beta} z 0 = c B T β
若λ j ⩾ 0 , 1 ⩽ j ⩽ n \lambda_j\geqslant 0, 1\leqslant j\leqslant n λ j ⩾ 0 , 1 ⩽ j ⩽ n x B = β , x N = 0 \boldsymbol{x}_B=\boldsymbol{\beta}, \boldsymbol{x}_N=\boldsymbol{0} x B = β , x N = 0 x \boldsymbol{x} x
否则,任取一个λ k < 0 \lambda_k<0 λ k < 0 α i k ⩽ 0 \alpha_{ik}\leqslant 0 α ik ⩽ 0
否则存在l l l α l k > 0 \alpha_{lk}>0 α l k > 0 l = arg min i , α i k > 0 { β i / α i k } l=\arg\min_{i, \alpha_{ik}>0}\{ \beta_i/\alpha_{ik}\} l = arg min i , α ik > 0 { β i / α ik }
以x k x_k x k x π ( l ) x_{\pi (l)} x π ( l )
3.5、单纯形表
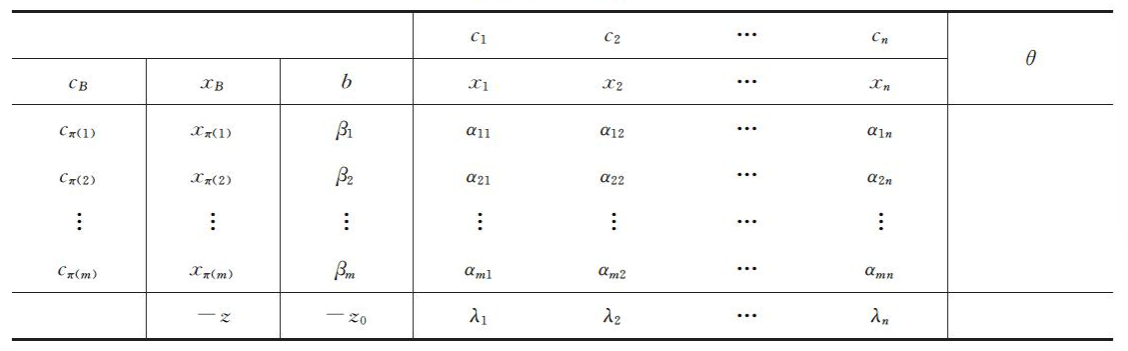
单纯形表如下图所示:
首先,来解释一下单纯形表的结构:
最中心的大矩形存放矩阵α \boldsymbol{\alpha} α
x B \boldsymbol{x}_B x B c B \boldsymbol{c}_B c B b \boldsymbol{b} b 最后一行存放检验数λ \boldsymbol{\lambda} λ
将简化的目标函数改写为− z + ∑ j = 1 n λ j x j = − z 0 -z+\sum_{j=1}^n \lambda_j \boldsymbol{x}_j=-z_0 − z + ∑ j = 1 n λ j x j = − z 0 ∑ j = 1 n α i j x j = β i \sum_{j=1}^n \alpha_{ij}x_j=\beta_i ∑ j = 1 n α ij x j = β i
由于选择的初始基B \boldsymbol{B} B α = A \boldsymbol{\alpha}=\boldsymbol{A} α = A c B = 0 \boldsymbol{c}_B=\boldsymbol{0} c B = 0 λ = c \boldsymbol{\lambda}=\boldsymbol{c} λ = c
接下来讲述怎么利用单纯形表进行计算。
初始化。按照上面的叙述,初始化单纯形表
检查λ j \lambda_j λ j c B \boldsymbol{c}_B c B b \boldsymbol{b} b z 0 z_0 z 0 λ k < 0 \lambda_k<0 λ k < 0 ∣ λ k ∣ |\lambda_k| ∣ λ k ∣ α \boldsymbol{\alpha} α k k k
否则,对每一个α i k > 0 \alpha_{ik}>0 α ik > 0 θ i = β i / α i k \theta_i=\beta_i/\alpha_{ik} θ i = β i / α ik θ \boldsymbol{\theta} θ θ l \theta_l θ l α l k \alpha_{lk} α l k x k x_k x k x π ( l ) x_{\pi (l)} x π ( l )
在单纯形表上做基变换的操作:
更新α , β , λ \boldsymbol{\alpha}, \boldsymbol{\beta}, \boldsymbol{\lambda} α , β , λ
将x B \boldsymbol{x}_B x B x π ( l ) \boldsymbol{x}_{\pi (l)} x π ( l ) x k \boldsymbol{x}_k x k c B \boldsymbol{c}_B c B c π ( l ) \boldsymbol{c}_{\pi (l)} c π ( l ) c k \boldsymbol{c}_k c k
这样,就得到了一张新的单纯形表,回到步骤 2
4、人工变量和两阶段法
4.1、人工变量
在 3.1 中,只讨论了对最简单的情况如何确定初始基本可行解。约束条件还有其他两种情况:
∑ j = 1 n a i j x j ⩾ b i \sum_{j=1}^n a_{ij}x_j \geqslant b_i ∑ j = 1 n a ij x j ⩾ b i ∑ j = 1 n a i j x j = b i \sum_{j=1}^n a_{ij}x_j = b_i ∑ j = 1 n a ij x j = b i
对于情况 1,引入剩余变量可以转化为情况 2。对于情况 2,引入人工变量 y i ⩾ 0 y_i\geqslant 0 y i ⩾ 0
∑ j = 1 n a i j x j + y i = b i \sum_{j=1}^n a_{ij}x_j +y_i = b_i
j = 1 ∑ n a ij x j + y i = b i
一开始取所有的松弛变量和人工变量得到初始可行基,以及相应初始基本可行解。
4.2、两阶段法
引入人工变量后求解,最终得到的解中,只有所有的人工变量值均为 0 时,才能直接舍弃掉人工变量,得到原问题的解。否则,是不满足约束条件的。
设原问题为:
min z = ∑ j = 1 n c j x j s.t. ∑ j = 1 n a i j x j = b i , 1 ⩽ i ⩽ m x j ⩾ 0 , 1 ⩽ j ⩽ n \begin{align*}
\min z=\sum_{j=1}^n c_jx_j\\
\text{s.t.} \sum_{j=1}^n a_{ij}x_j = b_i, & 1\leqslant i\leqslant m\\
x_j\geqslant 0,& 1\leqslant j\leqslant n
\end{align*}
min z = j = 1 ∑ n c j x j s.t. j = 1 ∑ n a ij x j = b i , x j ⩾ 0 , 1 ⩽ i ⩽ m 1 ⩽ j ⩽ n
引入人工变量x n + i , 1 ⩽ i ⩽ m x_{n+i}, 1\leqslant i\leqslant m x n + i , 1 ⩽ i ⩽ m
min w = ∑ i = 1 m x n + i s.t. ∑ j = 1 n a i j x j + x n + i = b i , 1 ⩽ i ⩽ m x j ⩾ 0 , 1 ⩽ j ⩽ n + m \begin{align*}
\min w=\sum_{i=1}^m x_{n+i}\\
\text{s.t.} \sum_{j=1}^n a_{ij}x_j +x_{n+i} = b_i, & 1\leqslant i\leqslant m\\
x_j\geqslant 0,& 1\leqslant j\leqslant n+m
\end{align*}
min w = i = 1 ∑ m x n + i s.t. j = 1 ∑ n a ij x j + x n + i = b i , x j ⩾ 0 , 1 ⩽ i ⩽ m 1 ⩽ j ⩽ n + m
由于w ⩾ 0 w\geqslant 0 w ⩾ 0 ( x 1 ∗ , x 2 ∗ , … , x n + m ∗ ) (x_1^*, x_2^*, \dots, x_{n+m}^*) ( x 1 ∗ , x 2 ∗ , … , x n + m ∗ ) w ∗ w^* w ∗
w ∗ > 0 w^*>0 w ∗ > 0 w ∗ = 0 w^*=0 w ∗ = 0 x n + i ∗ = 0 , 1 ⩽ i ⩽ m x_{n+i}^*=0, 1\leqslant i\leqslant m x n + i ∗ = 0 , 1 ⩽ i ⩽ m ( x 1 ∗ , x 2 ∗ , … , x n ∗ ) (x_1^*, x_2^*, \dots, x_n^*) ( x 1 ∗ , x 2 ∗ , … , x n ∗ ) w ∗ = 0 w^*=0 w ∗ = 0 x n + i ∗ = 0 , 1 ⩽ i ⩽ m x_{n+i}^*=0, 1\leqslant i\leqslant m x n + i ∗ = 0 , 1 ⩽ i ⩽ m x n + k x_{n+k} x n + k x n + k x_{n+k} x n + k r r r α x = β \boldsymbol{\alpha x}=\boldsymbol{\beta} αx = β ∑ j = 1 m + n α r j x j = β r ⇔ ∑ j = 1 n α r j x j + 1 ⋅ x n + k + ∑ 1 ⩽ j ⩽ m , j ≠ k α r , n + j x n + j = 0 \sum_{j=1}^{m+n} \alpha_{rj}x_j=\beta_r \Leftrightarrow \sum_{j=1}^{n} \alpha_{rj}x_j+1\cdot x_{n+k}+ \sum_{1\leqslant j\leqslant m, j\neq k} \alpha_{r, {n+j}}x_{n+j}=0
j = 1 ∑ m + n α r j x j = β r ⇔ j = 1 ∑ n α r j x j + 1 ⋅ x n + k + 1 ⩽ j ⩽ m , j = k ∑ α r , n + j x n + j = 0
说明原问题中m m m [ α β ] \begin{bmatrix} \boldsymbol{\alpha} & \boldsymbol{\beta} \end{bmatrix} [ α β ]
如果α r j , 1 ⩽ j ⩽ n \alpha_{rj}, 1\leqslant j\leqslant n α r j , 1 ⩽ j ⩽ n x n + k x_{n+k} x n + k
如果存在α r l ≠ 0 \alpha_{rl} \neq 0 α r l = 0 x l x_{l} x l x ∗ n + k x*{n+k} x ∗ n + k β ∗ r = 0 \beta*{r}=0 β ∗ r = 0 β \boldsymbol{\beta} β w w w
所以如果w ∗ = 0 w^*=0 w ∗ = 0
5、单纯形法的有限终止
如果基本可行解中基变量的值都大于 0, 则称这个基本可行解是非退化的 , 否则称作退化的 。
如果线性规划的所有基本可行解都是非退化的, 则称这个线性规划是非退化的。如果线性规划有可行解并且是非退化的, 则每一次基变换都会使目标函数值严格下降,从而在计算过程中,可行基不会从夫出现,因此单纯形法一定会在有限步内终止。
Bland 规则 指出:
当有多个λ j < 0 \lambda_j<0 λ j < 0
当有多个θ i = β i / α i k \theta_i=\beta_i/\alpha_{ik} θ i = β i / α ik
按照 Bland 规则选取换入换出变量,可以保证单纯形法的有限终止。
6、对偶性
设线性规划:
max c T x s.t. A x ⩽ b x ⩾ 0 \begin{align*}
\max \boldsymbol{c}^T\boldsymbol{x}\\
\text{s.t.} \boldsymbol{A}\boldsymbol{x}\leqslant \boldsymbol{b}\\
\boldsymbol{x}\geqslant \boldsymbol{0}
\end{align*}
max c T x s.t. A x ⩽ b x ⩾ 0
其对偶线性规划(也简称对偶/对偶规划)为:
min b T y s.t. A T y ⩾ c y ⩾ 0 \begin{align*}
\min \boldsymbol{b}^T\boldsymbol{y}\\
\text{s.t.} \boldsymbol{A}^T\boldsymbol{y}\geqslant \boldsymbol{c}\\
\boldsymbol{y}\geqslant \boldsymbol{0}
\end{align*}
min b T y s.t. A T y ⩾ c y ⩾ 0
第七章 网络流算法
1、有向图
图、节点、边的概念不在此赘述。
有向图可记作G = ( V , E ) G=(V, E) G = ( V , E ) V V V E E E e ∈ E e\in E e ∈ E ( i , j ) (i, j) ( i , j ) i , j ∈ V i, j\in V i , j ∈ V i i i j j j
从一个节点出发,到达另一个节点,所经过的边的序列称为一条路径 。路径上边的个数称为路径的长度 。
如果一个有向图从其中任何一个节点出发可以到达其他任何一个节点,则称这个有向图是强连通 的。
如果从有向图的一个节点出发到返回这个节点的路径的长度都是k k k k > 1 , k ∈ N k>1, k\in \mathcal{N} k > 1 , k ∈ N 周期性节点 。如果一个有向图不含周期性节点,则称这个有向图是非周期性图 (Aperiodic Graph),否则为周期性图 。
2、随机游走模型
给定一个含有n n n
具体来说,转移矩阵 M ∈ R n × n \boldsymbol{M}\in \mathbb{R}^{n\times n} M ∈ R n × n M i j \boldsymbol{M}_{ij} M ij j j j i i i j j j k k k j j j i i i M i j = 1 / k \boldsymbol{M}_{ij}=1/k M ij = 1/ k M i j = 0 \boldsymbol{M}_{ij}=0 M ij = 0
显然,转移矩阵满足以下性质:
m i j ⩾ 0 m_{ij}\geqslant 0 m ij ⩾ 0 ∑ i = 1 n m i j = 1 , ∀ j \sum_{i=1}^n m_{ij}=1, \forall j ∑ i = 1 n m ij = 1 , ∀ j
转移矩阵就是一个随机矩阵 。
随机游走者每经过一个单位时间转移一个状态,假设当前时刻在第j j j j j j i i i M i j \boldsymbol{M}_{ij} M ij
随机游走者在某个时刻t t t n n n R t R_t R t t t t
R t + 1 = M T R t R_{t+1}=\boldsymbol{M}^T R_t
R t + 1 = M T R t
将网页看作节点,网页之间的跳转看作边,构成一个有向图。浏览者随机浏览网页,构成一个随机游走模型。
PageRank 是一个函数,输入是网页,输出是一个实数值,表示这个网页的重要性。得到 PageRank 值的一种方法是:假定浏览者随机游走的情况下,考虑其某个时刻停留在某个页面的概率,这个概率值就作为这个页面的 PageRank 值。所以 PageRank 就是该随机游走模型的平稳分布,每个页面的 PageRank 值就是平稳概率。
3.1、基本定义
给定一个包含n n n v 1 , v 2 , … , v n v_1, v_2, \dots, v_n v 1 , v 2 , … , v n 强连通的,非周期性 的有向图。在有向图上定义随机游走模型,即一阶马尔科夫链,其转移矩阵为M \boldsymbol{M} M R \boldsymbol{R} R R \boldsymbol{R} R P R ( v i ) PR(v_i) PR ( v i )
考虑在时刻0 , 1 , 2 , … , t , … 0, 1, 2, \dots, t, \dots 0 , 1 , 2 , … , t , … R 0 , M R 0 , M 2 R 0 , … , M t R 0 , … \boldsymbol{R}_0, \boldsymbol{M}\boldsymbol{R}_0, \boldsymbol{M}^2\boldsymbol{R}_0, \dots, \boldsymbol{M}^t\boldsymbol{R}_0, \dots R 0 , M R 0 , M 2 R 0 , … , M t R 0 , …
由于不可约且非周期的有限状态马尔科夫链,由唯一平稳分布存在,并且当时间趋于无穷时的状态分布收敛于唯一的平稳分布。PageRank 问题的基本定义满足上述条件,所以极限:
lim t → + ∞ M t R 0 = R \lim_{t\to +\infty} \boldsymbol{M}^t\boldsymbol{R}_0=\boldsymbol{R}
t → + ∞ lim M t R 0 = R
存在。极限值R \boldsymbol{R} R M R = R \boldsymbol{M}\boldsymbol{R}=\boldsymbol{R} M R = R
记M ( v i ) M(v_i) M ( v i ) v i v_i v i L ( v j ) L(v_j) L ( v j ) v j v_j v j
PageRank 值满足以下性质:
P R ( v i ) ⩾ 0 PR(v_i)\geqslant 0 PR ( v i ) ⩾ 0 ∑ i = 1 n P R ( v i ) = 1 \sum_{i=1}^n PR(v_i)=1 ∑ i = 1 n PR ( v i ) = 1 P R ( v i ) = ∑ v j ∈ M ( v i ) P R ( v j ) L ( v j ) PR(v_i)=\sum_{v_j\in M(v_i)}\frac{PR(v_j)}{L(v_j)} PR ( v i ) = ∑ v j ∈ M ( v i ) L ( v j ) PR ( v j )
PageRank 的定义是明确的,可以通过迭代的方式求出R \boldsymbol{R} R
3.2、一般定义
有时候有向图并不满足强连通和非周期性的条件,则此时不一定能够得到有意义的R \boldsymbol{R} R
这就引出了 PageRank 的一般定义,其基本思想是在基本定义的基础上加入平滑项。考虑另一个完全随机游走模型,其转移矩阵的元素全部为1 / n 1/n 1/ n R \boldsymbol{R} R
R = d M R + 1 − d n 1 \boldsymbol{R}=d \boldsymbol{M}\boldsymbol{R}+\frac{1-d}{n}\boldsymbol{1}
R = d M R + n 1 − d 1
其中1 \boldsymbol{1} 1 d ∈ [ 0 , 1 ] d\in [0, 1] d ∈ [ 0 , 1 ] 阻尼因子 (Damping Factor),取值由经验决定。当d d d d d d
一般定义下的 PageRank 值满足以下性质:
P R ( v i ) = d ( ∑ v j ∈ M ( v i ) P R ( v j ) L ( v j ) ) + 1 − d n PR(v_i)=d\left(\sum_{v_j\in M(v_i)}\frac{PR(v_j)}{L(v_j)}\right)+\frac{1-d}{n}
PR ( v i ) = d v j ∈ M ( v i ) ∑ L ( v j ) PR ( v j ) + n 1 − d
等式右边第二项极为平滑项,它保证了\PR(v_i)>0,且仍有∑ i = 1 n P R ( v i ) = 1 \sum_{i=1}^n PR(v_i)=1 ∑ i = 1 n PR ( v i ) = 1
3.3.1、迭代法
有定义,直接按照以下迭代公式进行迭代即可,直到收敛或达到某种精度:
R t + 1 = d M R t + 1 − d n 1 \boldsymbol{R}_{t+1}=d\boldsymbol{M}\boldsymbol{R}_t+\frac{1-d}{n}\boldsymbol{1}
R t + 1 = d M R t + n 1 − d 1
3.3.2、幂法
考虑矩阵A ∈ R n × n \boldsymbol{A}\in\mathbb{R}^{n\times n} A ∈ R n × n n n n ∣ λ 1 ∣ > ∣ λ 2 ∣ ⩾ ⋯ ⩾ ∣ λ n ∣ |\lambda_1|>|\lambda_2|\geqslant \dots \geqslant |\lambda_n| ∣ λ 1 ∣ > ∣ λ 2 ∣ ⩾ ⋯ ⩾ ∣ λ n ∣ u 1 , u 2 , … , u n \boldsymbol{u}_1, \boldsymbol{u}_2, \dots, \boldsymbol{u}_n u 1 , u 2 , … , u n λ 1 \lambda_1 λ 1 A \boldsymbol{A} A 主特征值 ,u 1 \boldsymbol{u}_1 u 1 主特征向量 。幂法用于近似求解主特征向量。
n n n n n n x 0 \boldsymbol{x_0} x 0 x 0 = ∑ i = 1 n a u i x_0=\sum_{i=1}^n a \boldsymbol{u}_i x 0 = ∑ i = 1 n a u i λ 1 \lambda_1 λ 1
x k = A k x 0 = ∑ i = 1 n a λ i k u i = a 1 λ 1 k [ u 1 + ∑ i = 2 n ( λ i λ 1 ) k a i u i ] \boldsymbol{x_k}=\boldsymbol{A}^k x_0=\sum_{i=1}^n a \lambda_i^k \boldsymbol{u}_i=a_1 \lambda_1^k \left[\boldsymbol{u}_1+\sum_{i=2}^n \left(\frac{\lambda_i}{\lambda_1}\right)^k a_i \boldsymbol{u}_i\right]
x k = A k x 0 = i = 1 ∑ n a λ i k u i = a 1 λ 1 k [ u 1 + i = 2 ∑ n ( λ 1 λ i ) k a i u i ]
所以有:
lim k → + ∞ x k = a 1 λ 1 k u 1 \lim_{k\to +\infty}\boldsymbol{x_k}= a_1 \lambda_1^k \boldsymbol{u}_1
k → + ∞ lim x k = a 1 λ 1 k u 1
也即k k k x k \boldsymbol{x_k} x k u 1 \boldsymbol{u}_1 u 1
一般 PageRank 中,转移矩阵可写为:
R = d M R + 1 − d n 1 = ( d M + 1 − d n E ) R = A R \boldsymbol{R}=d \boldsymbol{M}\boldsymbol{R}+\frac{1-d}{n}\boldsymbol{1}=\left(d \boldsymbol{M}+\frac{1-d}{n}\boldsymbol{E}\right)\boldsymbol{R}=\boldsymbol{A}\boldsymbol{R}
R = d M R + n 1 − d 1 = ( d M + n 1 − d E ) R = A R
其中E \boldsymbol{E} E ∑ i = 1 n R i = 1 \sum_{i=1}^n R_i=1 ∑ i = 1 n R i = 1 E R = 1 \boldsymbol{E}\boldsymbol{R}=\boldsymbol{1} E R = 1
由 Perron-Frobenius 定理,R \boldsymbol{R} R A \boldsymbol{A} A
为了防止计算过程中出现绝对值过大或者过小的情况,过程中对x k \boldsymbol{x}_k x k x k ← x k / ∥ x k ∥ \boldsymbol{x}_k\leftarrow\boldsymbol{x}_k/\|\boldsymbol{x}_k\| x k ← x k /∥ x k ∥
3.3.3、直接法
根据定义,可以直接写出R \boldsymbol{R} R
R = 1 − d n ( I − d M ) − 1 1 \boldsymbol{R}=\frac{1-d}{n}(\boldsymbol{I}-d\boldsymbol{M})^{-1}\boldsymbol{1}
R = n 1 − d ( I − d M ) − 1 1
求解一个逆矩阵即可。
4、最大流问题
4.1、定义
定义容量网络 N = ( V , E , c , s , t ) N=(V, E, c, s, t) N = ( V , E , c , s , t )
( V , E ) (V, E) ( V , E ) n = ∣ V ∣ , m = ∣ E ∣ n=|V|, m=|E| n = ∣ V ∣ , m = ∣ E ∣ c : E → R + c:E\to \mathbb{R}^+ c : E → R + 容量 函数,表示边能够通过的最大流量s , t ∈ V s, t\in V s , t ∈ V 源点 (发点)和汇点 (收点),其余节点称为中间点。
流 可以用一个函数f : E → R + f: E\to \mathbb{R}^+ f : E → R + f ( ( i , j ) ) f((i, j)) f (( i , j )) f ( i , j ) f(i, j) f ( i , j ) c c c
容量限制 :f ( i , j ) ⩽ c ( i , j ) , ∀ ( i , j ) ∈ E f(i, j)\leqslant c(i, j), \forall (i, j)\in E f ( i , j ) ⩽ c ( i , j ) , ∀ ( i , j ) ∈ E 平衡条件 :∑ ( j , i ) ∈ E f ( j , i ) − ∑ ( i , j ) ∈ E f ( i , j ) = 0 , ∀ i ∈ V − { s , t } \sum_{(j, i) \in E} f(j, i)-\sum_{(i, j)\in E} f(i, j)=0, \forall i\in V-\{s, t\} ∑ ( j , i ) ∈ E f ( j , i ) − ∑ ( i , j ) ∈ E f ( i , j ) = 0 , ∀ i ∈ V − { s , t }
则称f f f N N N 可行流 。
称源点s s s f f f 流量 ,记作v ( f ) v(f) v ( f )
v ( f ) = ∑ ( s , i ) ∈ E f ( s , i ) − ∑ ( i , s ) ∈ E f ( i , s ) v(f)=\sum_{(s, i)\in E} f(s, i)-\sum_{(i, s)\in E} f(i, s)
v ( f ) = ( s , i ) ∈ E ∑ f ( s , i ) − ( i , s ) ∈ E ∑ f ( i , s )
流量最大的流称为最大流 。显然有:
v ( f ) = ∑ ( i , t ) ∈ E f ( i , t ) − ∑ ( t , i ) ∈ E f ( t , i ) v(f)=\sum_{(i, t)\in E} f(i, t)-\sum_{(t, i)\in E} f(t, i)
v ( f ) = ( i , t ) ∈ E ∑ f ( i , t ) − ( t , i ) ∈ E ∑ f ( t , i )
也即源点的净流出量等于汇点的净流入量。
最大流问题的线性规划形式可以写为:
max v ( f ) s.t. f ( i , j ) ⩽ c ( i , j ) , ∀ ( i , j ) ∈ E ∑ ( j , i ) ∈ E f ( j , i ) − ∑ ( i , j ) ∈ E f ( i , j ) = 0 , ∀ i ∈ V − { s , t } v ( f ) = ∑ ( s , i ) ∈ E f ( s , i ) − ∑ ( i , s ) ∈ E f ( i , s ) f ( i , j ) ⩾ 0 , ∀ ( i , j ) ∈ E v ( f ) ⩾ 0 \begin{align*}
\max & v(f)\\
\text{s.t.} & f(i, j)\leqslant c(i, j), \forall (i, j)\in E\\
& \sum_{(j, i) \in E} f(j, i)-\sum_{(i, j)\in E} f(i, j)=0, \forall i\in V-\{s, t\}\\
& v(f)=\sum_{(s, i)\in E} f(s, i)-\sum_{(i, s)\in E} f(i, s) \\
& f(i, j)\geqslant 0, \forall (i, j)\in E\\
& v(f)\geqslant 0 \\
\end{align*}
max s.t. v ( f ) f ( i , j ) ⩽ c ( i , j ) , ∀ ( i , j ) ∈ E ( j , i ) ∈ E ∑ f ( j , i ) − ( i , j ) ∈ E ∑ f ( i , j ) = 0 , ∀ i ∈ V − { s , t } v ( f ) = ( s , i ) ∈ E ∑ f ( s , i ) − ( i , s ) ∈ E ∑ f ( i , s ) f ( i , j ) ⩾ 0 , ∀ ( i , j ) ∈ E v ( f ) ⩾ 0
能够求解线性规划的算法都能够求解最大流问题,但是最大流问题应用广泛,有很多专门的算法。
4.2、最小割集
设容量网络N = ( V , E , c , s , t ) N=(V, E, c, s, t) N = ( V , E , c , s , t ) A ⊂ V A\subset V A ⊂ V s ∈ A , t ∈ A ‾ s\in A, t\in \overline{A} s ∈ A , t ∈ A
( A , A ‾ ) = { ( i , j ) ∈ E ∣ i ∈ A , j ∈ A ‾ } (A, \overline{A})=\{(i, j)\in E|i\in A, j\in \overline{A}\}
( A , A ) = {( i , j ) ∈ E ∣ i ∈ A , j ∈ A }
为N N N 割集 。
扩展容量函数c c c
c ( A , A ‾ ) = ∑ ( i , j ) ∈ ( A , A ‾ ) c ( i , j ) c(A, \overline{A})=\sum_{(i, j)\in (A, \overline{A})} c(i, j)
c ( A , A ) = ( i , j ) ∈ ( A , A ) ∑ c ( i , j )
容量最小的割集就称为最小割集 。
引理 1 :若f f f N N N ( A , A ‾ ) (A, \overline{A}) ( A , A )
v ( f ) = ∑ ( i , j ) ∈ ( A , A ‾ ) f ( i , j ) − ∑ ( j , i ) ∈ ( A , A ‾ ) f ( j , i ) v(f)=\sum_{(i, j)\in (A, \overline{A})} f(i, j)-\sum_{(j, i)\in (A, \overline{A})} f(j, i)
v ( f ) = ( i , j ) ∈ ( A , A ) ∑ f ( i , j ) − ( j , i ) ∈ ( A , A ) ∑ f ( j , i )
也即整个网络上的流量,等于割集上的流量。
证明:从v ( f ) v(f) v ( f )
v ( f ) = ∑ ( s , i ) ∈ E f ( s , i ) − ∑ ( i , s ) ∈ E f ( i , s ) = ∑ ( s , i ) ∈ E f ( s , i ) − ∑ ( i , s ) ∈ E f ( i , s ) + ∑ i ∈ A − { s } ( ∑ ( j , i ) ∈ E f ( j , i ) − ∑ ( i , j ) ∈ E f ( i , j ) ) = ∑ i ∈ A ( ∑ ( j , i ) ∈ E f ( j , i ) − ∑ ( i , j ) ∈ E f ( i , j ) ) = ∑ i ∈ A ∑ ( i , j ) ∈ E f ( i , j ) − ∑ i ∈ A ∑ ( j , i ) ∈ E f ( j , i ) = ( ∑ i ∈ A , j ∈ A ∑ ( i , j ) ∈ E f ( i , j ) + ∑ i ∈ A , j ∈ A ‾ ∑ ( i , j ) ∈ E f ( i , j ) ) − ( ∑ i ∈ A , j ∈ A ) ∑ ( j , i ) ∈ E f ( j , i ) + ∑ i ∈ A , j ∈ A ‾ ∑ ( j , i ) ∈ E f ( j , i ) ) = ∑ ( i , j ) ∈ ( A , A ‾ ) f ( i , j ) − ∑ ( j , i ) ∈ ( A , A ‾ ) f ( j , i ) \begin{align*}
v(f)&=\sum_{(s, i)\in E} f(s, i)-\sum_{(i, s)\in E} f(i, s)\\
&=\sum_{(s, i)\in E} f(s, i)-\sum_{(i, s)\in E} f(i, s)+\sum_{i\in A-\{s\}}\left(\sum_{(j, i)\in E} f(j, i)-\sum_{(i, j)\in E} f(i, j)\right)\\
&=\sum_{i\in A}\left(\sum_{(j, i)\in E} f(j, i)-\sum_{(i, j)\in E} f(i, j)\right)\\
&=\sum_{i\in A}\sum_{(i, j)\in E} f(i, j)-\sum_{i\in A}\sum_{(j, i)\in E} f(j, i)\\
&=\left(\sum_{i\in A, j\in A}\sum_{(i, j)\in E} f(i, j)+\sum_{i\in A, j\in \overline{A}}\sum_{(i, j)\in E} f(i, j)\right)-\left(\sum_{i\in A, j\in A})\sum_{(j, i)\in E} f(j, i)+\sum_{i\in A, j\in \overline{A}}\sum_{(j, i)\in E} f(j, i)\right)\\
&=\sum_{(i, j)\in (A, \overline{A})} f(i, j)-\sum_{(j, i)\in (A, \overline{A})} f(j, i)
\end{align*}
v ( f ) = ( s , i ) ∈ E ∑ f ( s , i ) − ( i , s ) ∈ E ∑ f ( i , s ) = ( s , i ) ∈ E ∑ f ( s , i ) − ( i , s ) ∈ E ∑ f ( i , s ) + i ∈ A − { s } ∑ ( j , i ) ∈ E ∑ f ( j , i ) − ( i , j ) ∈ E ∑ f ( i , j ) = i ∈ A ∑ ( j , i ) ∈ E ∑ f ( j , i ) − ( i , j ) ∈ E ∑ f ( i , j ) = i ∈ A ∑ ( i , j ) ∈ E ∑ f ( i , j ) − i ∈ A ∑ ( j , i ) ∈ E ∑ f ( j , i ) = i ∈ A , j ∈ A ∑ ( i , j ) ∈ E ∑ f ( i , j ) + i ∈ A , j ∈ A ∑ ( i , j ) ∈ E ∑ f ( i , j ) − i ∈ A , j ∈ A ∑ ) ( j , i ) ∈ E ∑ f ( j , i ) + i ∈ A , j ∈ A ∑ ( j , i ) ∈ E ∑ f ( j , i ) = ( i , j ) ∈ ( A , A ) ∑ f ( i , j ) − ( j , i ) ∈ ( A , A ) ∑ f ( j , i )
引理 2 :若f f f N N N ( A , A ‾ ) (A, \overline{A}) ( A , A )
v ( f ) ⩽ c ( A , A ‾ ) v(f)\leqslant c(A, \overline{A})
v ( f ) ⩽ c ( A , A )
证明:
v ( f ) = ∑ ( i , j ) ∈ ( A , A ‾ ) f ( i , j ) − ∑ ( j , i ) ∈ ( A , A ‾ ) f ( j , i ) ⩽ ∑ ( i , j ) ∈ ( A , A ‾ ) f ( i , j ) ⩽ ∑ ( i , j ) ∈ ( A , A ‾ ) c ( i , j ) = c ( A , A ‾ ) \begin{align*}
v(f)&=\sum_{(i, j)\in (A, \overline{A})} f(i, j)-\sum_{(j, i)\in (A, \overline{A})} f(j, i)\\
&\leqslant \sum_{(i, j)\in (A, \overline{A})} f(i, j)\\
& \leqslant \sum_{(i, j)\in (A, \overline{A})} c(i, j)=c(A, \overline{A})
\end{align*}
v ( f ) = ( i , j ) ∈ ( A , A ) ∑ f ( i , j ) − ( j , i ) ∈ ( A , A ) ∑ f ( j , i ) ⩽ ( i , j ) ∈ ( A , A ) ∑ f ( i , j ) ⩽ ( i , j ) ∈ ( A , A ) ∑ c ( i , j ) = c ( A , A )
由引理 1、2,显然有引理 3 :设f f f N N N ( A , A ‾ ) (A, \overline{A}) ( A , A ) v ( f ) = c ( A , A ‾ ) v(f)=c(A, \overline{A}) v ( f ) = c ( A , A ) f f f ( A , A ‾ ) (A, \overline{A}) ( A , A )
4.3、最小割集的一个应用
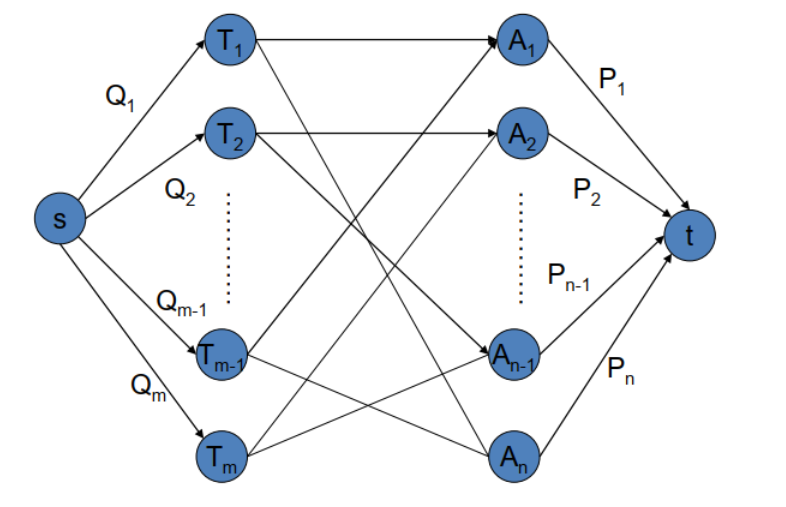
经营投资策略问题。假设开发产品A i A_i A i m i m_i m i T i 1 , T i 2 , … , T i m i T_{i_1}, T_{i_2}, \dots, T_{i_{m_i}} T i 1 , T i 2 , … , T i m i T i T_i T i Q i Q_i Q i A i A_i A i P i P_i P i
考虑构建一个这样的容量网络:
如果产品A i A_i A i T j T_j T j T j T_j T j A i A_i A i
以选择开发所有正净利润产品为例。将净利润为正的产品以及所需工具,放入汇点集合A ‾ ;净利润为负的产品, \overline{A};净利润为负的产品, A ;净利润为负的产品, A A A
从源点到正净利润产品所需的工具的边,这些边的容量之和代表成本
从负净利润产品到汇点的边,这些边的容量之和代表负净利润产品的收益,我们不开发这些产品
用所有产品的收益之和减掉这个割集的容量,就是最终的利润。所以,求出最小割集的容量,就能得到最大利润。
4.4、增广链
设f f f N N N
饱和边 :流量等于容量的边非饱和边 :流量小于容量的边零流边 :流量为 0 的边非零流边 :流量不为 0 的边
N N N i i i j j j i-j 链 。i-j 链的方向是从i i i j j j 前向边 ,与链方向相反的边称为后向边 。
i-j 增广链 是前向边均为非饱和边,后向边均为非零流边的 i-j 链。
如果N N N f f f E f , E b E_f, E_b E f , E b
δ = min { min e ∈ E f ( c ( e ) − f ( e ) ) , min e ∈ E b f ( e ) } \delta=\min\{\min_{e\in E_f} (c(e)-f(e)), \min_{e\in E_b} f(e)\}
δ = min { e ∈ E f min ( c ( e ) − f ( e )) , e ∈ E b min f ( e )}
可以构造一个新的流:
f ′ ( e ) = { f ( e ) + δ , e ∈ E f f ( e ) − δ , e ∈ E b f ( e ) , o t h e r w i s e f'(e)=\begin{cases}
f(e)+\delta, & e\in E_f\\
f(e)-\delta, & e\in E_b\\
f(e), & otherwise
\end{cases}
f ′ ( e ) = ⎩ ⎨ ⎧ f ( e ) + δ , f ( e ) − δ , f ( e ) , e ∈ E f e ∈ E b o t h er w i se
易有,f ′ f' f ′ v ( f ′ ) = v ( f ) + δ v(f')=v(f)+\delta v ( f ′ ) = v ( f ) + δ δ \delta δ
定理 1 :可行流f f f f f f
证明:由上面的叙述以及反证法,易证得必要性。下面证明充分性。
假设不存在关于f f f s s s j j j A A A t ∉ A t\notin A t ∈ / A ( A , A ‾ ) (A, \overline{A}) ( A , A )
f ( i , j ) = c ( i , j ) , ∀ ( i , j ) ∈ ( A , A ‾ ) f(i, j)=c(i, j), \forall (i, j)\in (A, \overline{A}) f ( i , j ) = c ( i , j ) , ∀ ( i , j ) ∈ ( A , A ) f ( i , j ) = 0 , ∀ ( i , j ) ∈ ( A ‾ , A ) f(i, j)=0, \forall (i, j)\in (\overline{A}, A) f ( i , j ) = 0 , ∀ ( i , j ) ∈ ( A , A )
对于其中第一点,若不然,存在( i , j ) ∈ ( A , A ‾ ) (i, j)\in (A, \overline{A}) ( i , j ) ∈ ( A , A ) f ( i , j ) < c ( i , j ) f(i, j)<c(i, j) f ( i , j ) < c ( i , j ) j ∈ A ‾ j\in \overline{A} j ∈ A
于是:
v ( f ) = ∑ ( i , j ) ∈ ( A , A ‾ ) f ( i , j ) − ∑ ( j , i ) ∈ ( A , A ‾ ) f ( j , i ) = ∑ ( i , j ) ∈ ( A , A ‾ ) c ( i , j ) = c ( A , A ‾ ) v(f)=\sum_{(i, j)\in (A, \overline{A})} f(i, j)-\sum_{(j, i)\in (A, \overline{A})} f(j, i)=\sum_{(i, j)\in (A, \overline{A})} c(i, j)=c(A, \overline{A})
v ( f ) = ( i , j ) ∈ ( A , A ) ∑ f ( i , j ) − ( j , i ) ∈ ( A , A ) ∑ f ( j , i ) = ( i , j ) ∈ ( A , A ) ∑ c ( i , j ) = c ( A , A )
由引理 3,可知f f f
定理 1 的证明中,还同时证明了 ( A , A ‾ ) (A, \overline{A}) ( A , A )
定理 2(最大流-最小割定理) :容量网络最大流的流量等于最小割集的容量。
5、Ford-Fulkerson 算法
简称 FF 算法,是解决最大流问题的一个经典算法。其基本思想是不断寻找增广链,修改链上的流量,直到不存在增广链为止,从而得到最大流。
从s s s t t t j j j s s s j j j ( l j , δ j ) (l_j, \delta_j) ( l j , δ j )
l j = + i l_j=+i l j = + i j j j i i i ( i , j ) (i, j) ( i , j ) l j = − i l_j=-i l j = − i j j j i i i ( j , i ) (j, i) ( j , i ) δ j \delta_j δ j δ \delta δ
将顶点分为三类:已标号已检查的、已标号未检查的T T T R R R
一开始,所有的点都是未标号的R = V R=V R = V
给s s s ( Δ , + ∞ ) (\Delta, +\infin) ( Δ , + ∞ ) T = { s } , R = V − { s } T=\{s\}, R=V-\{s\} T = { s } , R = V − { s }
从T T T i i i
循环遍历R R R i i i j j j
如果 f ( i , j ) < c ( i , j ) f(i, j)<c(i, j) f ( i , j ) < c ( i , j ) j j j ( + i , δ j ) (+i, \delta_j) ( + i , δ j ) δ j = min { δ i , c ( i , j ) − f ( i , j ) } \delta_j=\min\{\delta_i, c(i, j)-f(i, j)\} δ j = min { δ i , c ( i , j ) − f ( i , j )}
如果且 f ( j , i ) > 0 f(j, i)>0 f ( j , i ) > 0 j j j ( − i , δ j ) (-i, \delta_j) ( − i , δ j ) δ j = min { δ i , f ( j , i ) } \delta_j=\min\{\delta_i, f(j, i)\} δ j = min { δ i , f ( j , i )}
i i i T T T j j j R R R T T T
第 3 步中,若某轮循环中j = t j=t j = t T T T T T T s − t s-t s − t
从t t t { f ( i , j ) ← f ( i , j ) + δ j , j ← i , l j = + i f ( j , i ) ← f ( j , i ) − δ j , j ← i , l j = − i \begin{cases}
f(i, j)\leftarrow f(i, j)+\delta_j, j\leftarrow i, & l_j=+i\\
f(j, i)\leftarrow f(j, i)-\delta_j, j\leftarrow i, & l_j=-i
\end{cases}
{ f ( i , j ) ← f ( i , j ) + δ j , j ← i , f ( j , i ) ← f ( j , i ) − δ j , j ← i , l j = + i l j = − i
直到回溯到s s s
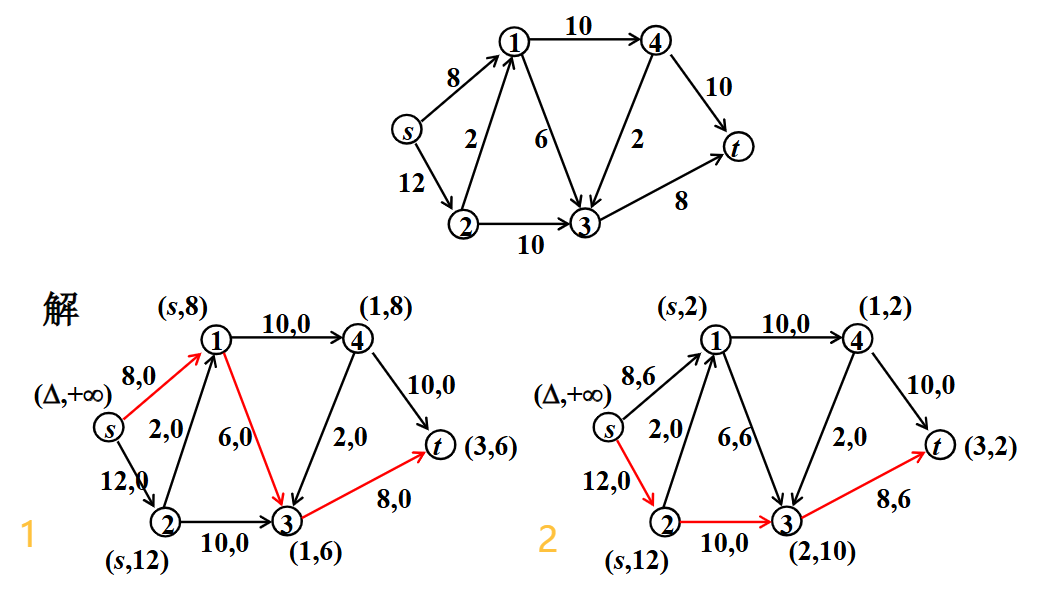
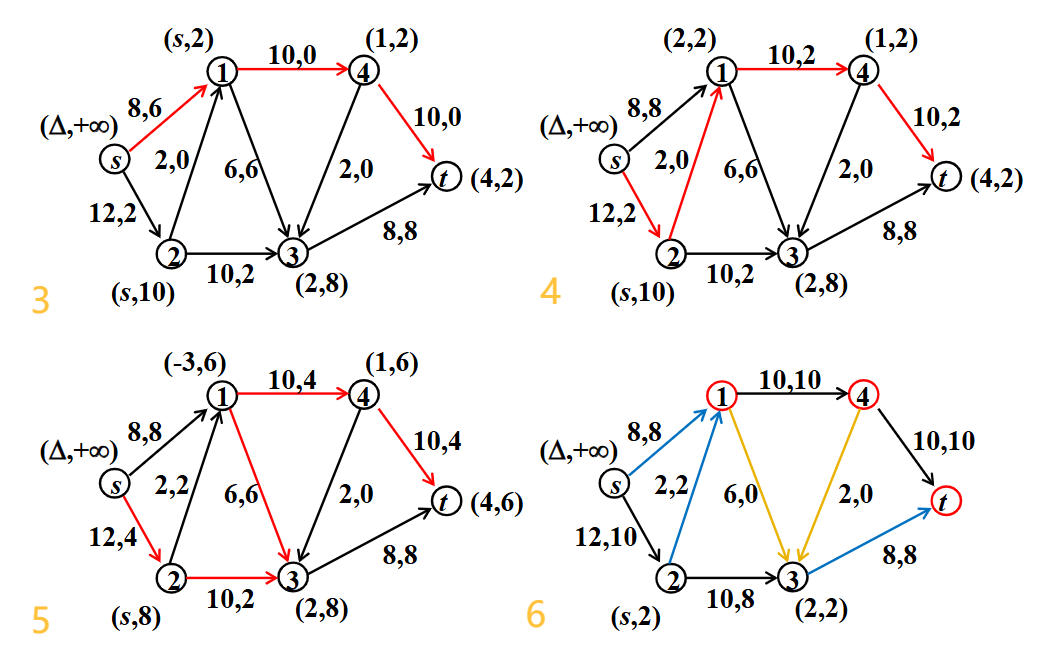
一个应用 FF 算法求最大流的例子如下:
假设所有的容量都是正整数,记C = ∑ ( i , j ) ∈ E c ( i , j ) C=\sum_{(i, j)\in E} c(i, j) C = ∑ ( i , j ) ∈ E c ( i , j ) C C C O ( m ) O(m) O ( m ) O ( m C ) O(mC) O ( m C )
计算机中,数的表示有一定的精度,所以算法总能在有限步内终止。理论上,容量为无理数时,δ \delta δ
6、Dinic 算法
FF 算法中,并没有明确给出标号过程的细节,找到的增广链以及找到不同增广链的顺序都是不固定的。而且 FF 算法每次只找一条增广链,就要重新标号,实际上也是一种浪费。
Dinic 算法对此进行了改进:
每次求最短的 s-t 增广链
充分利用一次标号的信息,每次找出尽可能多的增广链
6.1、辅助网络
定义一个关于容量网络N N N f f f 辅助网络 N f = ( V , E f , a c , s , t ) N_f=(V, E_f, ac, s, t) N f = ( V , E f , a c , s , t )
E f + = { ( i , j ) ∣ ( i , j ) ∈ E , f ( i , j ) < c ( i , j ) } E_f^+=\{(i, j)|(i, j)\in E, f(i, j)<c(i, j)\} E f + = {( i , j ) ∣ ( i , j ) ∈ E , f ( i , j ) < c ( i , j )} E f − = { ( j , i ) ∣ ( i , j ) ∈ E , f ( i , j ) > 0 } E_f^-=\{(j, i)|(i, j)\in E, f(i, j)>0\} E f − = {( j , i ) ∣ ( i , j ) ∈ E , f ( i , j ) > 0 } E f = E f + ∪ E f − E_f=E_f^+\cup E_f^- E f = E f + ∪ E f −
a c ac a c 辅助容量 函数,定义如下:
a c ( i , j ) = { c ( i , j ) − f ( i , j ) , ( i , j ) ∈ E f + f ( j , i ) , ( i , j ) ∈ E f − ac(i, j)=\begin{cases}
c(i, j)-f(i, j), & (i, j)\in E_f^+\\
f(j, i), & (i, j)\in E_f^-\\
\end{cases}
a c ( i , j ) = { c ( i , j ) − f ( i , j ) , f ( j , i ) , ( i , j ) ∈ E f + ( i , j ) ∈ E f −
正向边的容量,是原网络上该边剩余的容量;反向边的容量,是原网络上该边当前的流量,也即能退回的容量。
显然N f N_f N f f f f
这样构建的一个辅助网络,是原网络的一个子网络。如果存在一条 s 到 t 的路径,且路径上每条边的辅助容量都大于 0,则这条路径就是原网络上的一条增广链。
引理 4 :设N N N v ∗ v^* v ∗ f f f N N N N f N_f N f v ∗ − v ( f ) v^*-v(f) v ∗ − v ( f ) f f f
证明:由于N N N N f N_f N f N N N ( A , A ‾ ) (A, \overline{A}) ( A , A ) N f N_f N f ( A , A ‾ ) f (A, \overline{A})_f ( A , A ) f
a c ( A , A ‾ ) f = ∑ ( i , j ) ∈ E f + [ c ( i , j ) − f ( i , j ) ] + ∑ ( i , j ) ∈ E f − f ( j , i ) = ∑ ( i , j ) ∈ ( A , A ‾ ) [ c ( i , j ) − f ( i , j ) ] + ∑ ( i , j ) ∈ ( A ‾ , A ) f ( j , i ) = ∑ ( i , j ) ∈ ( A , A ‾ ) c ( i , j ) − [ ∑ ( i , j ) ∈ ( A , A ‾ ) f ( i , j ) − ∑ ( i , j ) ∈ ( A ‾ , A ) f ( j , i ) ] = c ( A , A ‾ ) − v ( f ) \begin{align*}
ac(A, \overline{A})_f&=\sum_{(i, j)\in E_f^+}[c(i, j)-f(i, j)]+\sum_{(i, j)\in E_f^-}f(j, i)\\
&=\sum_{(i, j)\in (A, \overline{A})}[c(i, j)-f(i, j)]+\sum_{(i, j)\in (\overline{A}, A)}f(j, i)\\
&=\sum_{(i, j)\in (A, \overline{A})}c(i, j)-\left[\sum_{(i, j)\in (A, \overline{A})}f(i, j)-\sum_{(i, j)\in (\overline{A}, A)}f(j, i)\right]\\
&=c(A, \overline{A})-v(f)
\end{align*}
a c ( A , A ) f = ( i , j ) ∈ E f + ∑ [ c ( i , j ) − f ( i , j )] + ( i , j ) ∈ E f − ∑ f ( j , i ) = ( i , j ) ∈ ( A , A ) ∑ [ c ( i , j ) − f ( i , j )] + ( i , j ) ∈ ( A , A ) ∑ f ( j , i ) = ( i , j ) ∈ ( A , A ) ∑ c ( i , j ) − ( i , j ) ∈ ( A , A ) ∑ f ( i , j ) − ( i , j ) ∈ ( A , A ) ∑ f ( j , i ) = c ( A , A ) − v ( f )
由最大流最小割定理即得证。
设f f f N N N g g g N f N_f N f g ( i , j ) = 0 , ∀ ( i , j ) ∉ E f g(i, j)=0, \forall (i, j)\notin E_f g ( i , j ) = 0 , ∀ ( i , j ) ∈ / E f E E E f ′ = f + g f'=f+g f ′ = f + g
f ′ ( i , j ) = f ( i , j ) + g ( i , j ) − g ( j , i ) , ∀ ( i , j ) ∈ E f'(i, j)=f(i, j)+g(i, j)-g(j, i), \forall (i, j)\in E
f ′ ( i , j ) = f ( i , j ) + g ( i , j ) − g ( j , i ) , ∀ ( i , j ) ∈ E
则有引理 5 :f ′ f' f ′ N N N v ( f ′ ) = v ( f ) + v ( g ) v(f')=v(f)+v(g) v ( f ′ ) = v ( f ) + v ( g )
证明:首先证明f ′ f' f ′
对于容量限制条件,由于0 ⩽ g ( i , j ) ⩽ c ( i , j ) − f ( i , j ) , 0 ⩽ g ( j , i ) ⩽ f ( i , j ) 0\leqslant g(i, j)\leqslant c(i, j)-f(i, j), 0\leqslant g(j, i)\leqslant f(i, j) 0 ⩽ g ( i , j ) ⩽ c ( i , j ) − f ( i , j ) , 0 ⩽ g ( j , i ) ⩽ f ( i , j )
0 ⩽ f ′ ( i , j ) = f ( i , j ) + g ( i , j ) − g ( j , i ) ⩽ c ( i , j ) 0\leqslant f'(i, j)=f(i, j)+g(i, j)-g(j, i)\leqslant c(i, j)
0 ⩽ f ′ ( i , j ) = f ( i , j ) + g ( i , j ) − g ( j , i ) ⩽ c ( i , j )
得证。
对于平衡条件,只需证对于所有中间点i i i ∑ ( j , i ) ∈ E f ′ ( j , i ) − ∑ ( i , j ) ∈ E f ′ ( i , j ) = 0 \sum_{(j, i)\in E} f'(j, i)-\sum_{(i, j)\in E} f'(i, j)=0 ∑ ( j , i ) ∈ E f ′ ( j , i ) − ∑ ( i , j ) ∈ E f ′ ( i , j ) = 0 ∀ i ∈ V − { s , t } \forall i\in V-\{s, t\} ∀ i ∈ V − { s , t }
∑ ( j , i ) ∈ E f ′ ( j , i ) = ∑ ( j , i ) ∈ E f ( j , i ) + ∑ ( j , i ) ∈ E , ( j , i ) ∈ E f g ( j , i ) − ∑ ( j , i ) ∈ E , ( i , j ) ∈ E f g ( i , j ) ∑ ( i , j ) ∈ E f ′ ( i , j ) = ∑ ( i , j ) ∈ E f ( i , j ) + ∑ ( i , j ) ∈ E , ( i , j ) ∈ E f g ( i , j ) − ∑ ( i , j ) ∈ E , ( j , i ) ∈ E f g ( j , i ) \begin{align*}
\sum_{(j, i)\in E} f'(j, i)&=\sum_{(j, i)\in E} f(j, i)+\sum_{(j, i)\in E, (j, i)\in E_f}g(j, i)-\sum_{(j, i)\in E, (i, j)\in E_f}g(i, j)\\
\sum_{(i, j)\in E} f'(i, j)&=\sum_{(i, j)\in E} f(i, j)+\sum_{(i, j)\in E, (i, j)\in E_f}g(i, j)-\sum_{(i, j)\in E, (j, i)\in E_f}g(j, i)
\end{align*}
( j , i ) ∈ E ∑ f ′ ( j , i ) ( i , j ) ∈ E ∑ f ′ ( i , j ) = ( j , i ) ∈ E ∑ f ( j , i ) + ( j , i ) ∈ E , ( j , i ) ∈ E f ∑ g ( j , i ) − ( j , i ) ∈ E , ( i , j ) ∈ E f ∑ g ( i , j ) = ( i , j ) ∈ E ∑ f ( i , j ) + ( i , j ) ∈ E , ( i , j ) ∈ E f ∑ g ( i , j ) − ( i , j ) ∈ E , ( j , i ) ∈ E f ∑ g ( j , i )
所以:
∑ ( j , i ) ∈ E f ′ ( j , i ) − ∑ ( i , j ) ∈ E f ′ ( i , j ) = [ ∑ ( j , i ) ∈ E f ( j , i ) − ∑ ( i , j ) ∈ E f ( i , j ) ] + [ ∑ ( j , i ) ∈ E f g ( j , i ) − ∑ ( i , j ) ∈ E f g ( i , j ) ] = 0 + 0 = 0 \begin{align*}
\sum_{(j, i)\in E} f'(j, i)-\sum_{(i, j)\in E} f'(i, j)&=\left[\sum_{(j, i)\in E} f(j, i)-\sum_{(i, j)\in E} f(i, j)\right]+\left[\sum_{(j, i)\in E_f}g(j, i)-\sum_{(i, j)\in E_f}g(i, j)\right]\\
&=0+0=0
\end{align*}
( j , i ) ∈ E ∑ f ′ ( j , i ) − ( i , j ) ∈ E ∑ f ′ ( i , j ) = ( j , i ) ∈ E ∑ f ( j , i ) − ( i , j ) ∈ E ∑ f ( i , j ) + ( j , i ) ∈ E f ∑ g ( j , i ) − ( i , j ) ∈ E f ∑ g ( i , j ) = 0 + 0 = 0
因此,f ′ f' f ′ N N N
又因为
v ( f ′ ) = ∑ ( s , j ) ∈ E [ f ( s , j ) + g ( s , j ) − g ( j , s ) ] − ∑ ( j , s ) ∈ E [ f ( j , s ) + g ( j , s ) − g ( s , j ) ] = [ ∑ ( s , j ) ∈ E f ( s , j ) + ∑ ( s , j ) ∈ E , ( s , j ) ∈ E f g ( s , j ) − ∑ ( s , j ) ∈ E , ( j , s ) ∈ E f g ( j , s ) ] − [ ∑ ( j , s ) ∈ E f ( j , s ) + ∑ ( j , s ) ∈ E , ( j , s ) ∈ E f g ( j , s ) − ∑ ( j , s ) ∈ E , ( s , j ) ∈ E f g ( s , j ) ] = [ ∑ ( s , j ) ∈ E f ( s , j ) − ∑ ( j , s ) ∈ E f ( j , s ) ] + [ ∑ ( s , j ) ∈ E f g ( s , j ) − ∑ ( j , s ) ∈ E f g ( j , s ) ] = v ( f ) + v ( g ) \begin{align*}
v(f')&=\sum_{(s, j)\in E}[f(s, j)+g(s, j)-g(j, s)]-\sum_{(j, s)\in E}[f(j, s)+g(j, s)-g(s, j)]\\
&=\left[ \sum_{(s, j)\in E}f(s, j)+\sum_{(s, j)\in E, (s, j)\in E_f}g(s, j)-\sum_{(s, j)\in E, (j, s)\in E_f}g(j, s) \right]-\left[ \sum_{(j, s)\in E}f(j, s)+\sum_{(j, s)\in E, (j, s)\in E_f}g(j, s)-\sum_{(j, s)\in E, (s, j)\in E_f}g(s, j) \right]\\
&=\left[ \sum_{(s, j)\in E}f(s, j)-\sum_{(j, s)\in E}f(j, s) \right] + \left[ \sum_{(s, j)\in E_f}g(s, j)-\sum_{(j, s)\in E_f}g(j, s) \right]\\
&=v(f)+v(g)
\end{align*}
v ( f ′ ) = ( s , j ) ∈ E ∑ [ f ( s , j ) + g ( s , j ) − g ( j , s )] − ( j , s ) ∈ E ∑ [ f ( j , s ) + g ( j , s ) − g ( s , j )] = ( s , j ) ∈ E ∑ f ( s , j ) + ( s , j ) ∈ E , ( s , j ) ∈ E f ∑ g ( s , j ) − ( s , j ) ∈ E , ( j , s ) ∈ E f ∑ g ( j , s ) − ( j , s ) ∈ E ∑ f ( j , s ) + ( j , s ) ∈ E , ( j , s ) ∈ E f ∑ g ( j , s ) − ( j , s ) ∈ E , ( s , j ) ∈ E f ∑ g ( s , j ) = ( s , j ) ∈ E ∑ f ( s , j ) − ( j , s ) ∈ E ∑ f ( j , s ) + ( s , j ) ∈ E f ∑ g ( s , j ) − ( j , s ) ∈ E f ∑ g ( j , s ) = v ( f ) + v ( g )
故引理得证。
这个引理提供了一个标准操作:当你在原始网络中有一个流 f f f N f N_f N f g g g f f f g g g f f f N N N
对于 g g g ( i , j ) ∈ E (i, j)\in E ( i , j ) ∈ E + g ( i , j ) +g(i, j) + g ( i , j ) g g g ( j , i ) ∈ E (j, i)\in E ( j , i ) ∈ E ( i , j ) (i, j) ( i , j ) − g ( j , i ) -g(j, i) − g ( j , i )
有了引理 4 和 5,Dinic 算法的基本思路就很清晰了:通过找到 N f N_f N f N N N
6.2、分层辅助网络
在N f N_f N f i i i s s s d ( i ) d(i) d ( i ) s s s N f N_f N f 分层辅助网络 A N f = ( V f , A E f , a c , s , t ) AN_{f}=(V_f, AE_f, ac, s, t) A N f = ( V f , A E f , a c , s , t )
V f ( k ) = { i ∈ V f ∣ d ( i ) = k } , 0 ⩽ k ⩽ d ( t ) V_{f}^{(k)}=\{i\in V_f|d(i)=k\}, 0\leqslant k\leqslant d(t) V f ( k ) = { i ∈ V f ∣ d ( i ) = k } , 0 ⩽ k ⩽ d ( t ) V f = ⋃ k = 0 d ( t ) V f ( k ) V_f=\bigcup_{k=0}^{d(t)} V_f^{(k)} V f = ⋃ k = 0 d ( t ) V f ( k )
分层辅助网络的边集定义为:
A E f = ⋃ k = 0 d ( t ) − 1 { ( i , j ) ∈ E f ∣ i ∈ V f ( k ) , j ∈ V f ( k + 1 ) } AE_f=\bigcup_{k=0}^{d(t)-1}\{(i, j)\in E_f|i\in V_f^{(k)}, j\in V_f^{(k+1)}\}
A E f = k = 0 ⋃ d ( t ) − 1 {( i , j ) ∈ E f ∣ i ∈ V f ( k ) , j ∈ V f ( k + 1 ) }
以下是一个带可行流的原始流量网络以及相应的辅助网络和分层辅助网络的示例,可以帮助理解三个网络的定义以及之间的关系:
可以直观地理解为,多层辅助网络是按照广度优先搜索顺序进行搜索时,看到的网络。
通过建立分层辅助网络,能保证每次都能找到最短的增广链。而且由于分层辅助网络是一个有向无环图,避免了走到环上浪费时间。
6.3、Dinic 最大流算法
定义分层辅助网络中,每一个顶点i i i 流通量 t h ( i ) th(i) t h ( i )
t h ( i ) = min { ∑ ( j , i ) ∈ A E f a c ( j , i ) , ∑ ( i , j ) ∈ A E f a c ( i , j ) } th(i)=\min\{\sum_{(j, i)\in AE_f} ac(j, i), \sum_{(i, j)\in AE_f} ac(i, j)\}
t h ( i ) = min { ( j , i ) ∈ A E f ∑ a c ( j , i ) , ( i , j ) ∈ A E f ∑ a c ( i , j )}
规定 a c ( i , s ) = + ∞ , a c ( t , j ) = + ∞ , ∀ i ∈ A E f ac(i, s)=+\infty, ac(t, j)=+\infty, \forall i\in AE_f a c ( i , s ) = + ∞ , a c ( t , j ) = + ∞ , ∀ i ∈ A E f
则 Dinic 最大流算法的完整叙述如下:
对于原始网络N N N f f f A N ( f ) AN(f) A N ( f )
如果A N ( f ) AN(f) A N ( f ) s s s t t t f f f N N N
初始化流g g g
查看A N f AN_f A N f s s s t t t f ← f + g f\leftarrow f+g f ← f + g
找到流通量最小的顶点k k k k k k t h ( k ) th(k) t h ( k ) s s s t t t g g g k k k
对于A N f AN_f A N f g ( i , j ) = a c ( i , j ) g(i, j)=ac(i, j) g ( i , j ) = a c ( i , j ) a c ( i , j ) ← a c ( i , j ) − g ( i , j ) ac(i, j)\leftarrow ac(i, j)-g(i, j) a c ( i , j ) ← a c ( i , j ) − g ( i , j )
对于上面那个示例中的分层辅助网络,Dinic 算法的执行过程如下:
首先可以依次删掉节点 9、7、5,因为它们的流通量会(变为) 0。然后找到流通量最小的顶点 1,其流通量为 3,向两边推送。
推送完毕后,删掉节点 1 和与其相连的边,再更新辅助网络的边容量。
接下来,继续找流通量最小的顶点。顶点 4 的流通量最小,为 2,重复上面的操作。会发现已经不存在从 s s s t t t f f f
根据新的 f f f
6.4、Dinic 算法的细节
引理 6 :在 Dinic 算法的某一轮结束时,分层辅助网络 A N f AN_f A N f s s s t t t g g g A N f AN_f A N f
证明:在 A N f AN_f A N f g g g A N f AN_f A N f g g g A N f AN_f A N f
这个引理保证了 Dinic 算法每一轮结束时,找到了分层辅助网络的极大流,从而保证了算法的正确性。
引理 7 :在每个阶段, A N f + g AN_{f+g} A N f + g A N f AN_f A N f + ∞ +\infty + ∞
证明:记 f ′ = f + g f'=f+g f ′ = f + g g g g
首先考虑原来在 A N f AN_f A N f N f + g N_{f+g} N f + g
对于 ∀ ( i , j ) ∈ A E f \forall (i, j)\in AE_f ∀ ( i , j ) ∈ A E f d ( i ) < d ( j ) d(i)<d(j) d ( i ) < d ( j ) ( i , j ) ∈ E (i, j)\in E ( i , j ) ∈ E E f + E_f^+ E f + a c ( i , j ) = c ( i , j ) − f ( i , j ) ac(i, j)=c(i, j)-f(i, j) a c ( i , j ) = c ( i , j ) − f ( i , j ) f ′ ( i , j ) = f ( i , j ) + g ( i , j ) f'(i, j)=f(i, j)+g(i, j) f ′ ( i , j ) = f ( i , j ) + g ( i , j )
当 g ( i , j ) < a c ( i , j ) g(i, j)<ac(i, j) g ( i , j ) < a c ( i , j ) f ′ ( i , j ) = c ( i , j ) − [ a c ( i , j ) − g ( i , j ) ] < c ( i , j ) f'(i, j)=c(i, j)-[ac(i, j)-g(i, j)]<c(i, j) f ′ ( i , j ) = c ( i , j ) − [ a c ( i , j ) − g ( i , j )] < c ( i , j ) ( i , j ) (i, j) ( i , j ) ( i , j ) ∈ E f + g (i, j)\in E_{f+g} ( i , j ) ∈ E f + g
当 g ( i , j ) = a c ( i , j ) g(i, j)=ac(i, j) g ( i , j ) = a c ( i , j ) f ′ ( i , j ) = c ( i , j ) f'(i, j)=c(i, j) f ′ ( i , j ) = c ( i , j ) ( i , j ) (i, j) ( i , j ) ( i , j ) ∉ E f + g (i, j)\notin E_{f+g} ( i , j ) ∈ / E f + g
此外,当 f ( i , j ) = 0 f(i, j)=0 f ( i , j ) = 0 g ( i , j ) > 0 g(i, j)>0 g ( i , j ) > 0 N f + g N_{f+g} N f + g N f N_f N f ( j , i ) (j, i) ( j , i ) d ( j ) > d ( i ) d(j)>d(i) d ( j ) > d ( i ) A N f + g AN_{f+g} A N f + g
对于 ∀ ( j , i ) ∈ E f \forall (j, i)\in E_f ∀ ( j , i ) ∈ E f d ( j ) < d ( i ) d(j)<d(i) d ( j ) < d ( i ) ( i , j ) ∈ E (i, j)\in E ( i , j ) ∈ E E f − E_f^- E f − a c ( j , i ) = f ( i , j ) ac(j, i)=f(i, j) a c ( j , i ) = f ( i , j ) f ′ ( i , j ) = f ( i , j ) − g ( j , i ) f'(i, j)=f(i, j)-g(j, i) f ′ ( i , j ) = f ( i , j ) − g ( j , i )
当 g ( j , i ) < a c ( j , i ) g(j, i)<ac(j, i) g ( j , i ) < a c ( j , i ) f ′ ( i , j ) = a c ( i , j ) − g ( j , i ) > 0 f'(i, j)=ac(i, j)-g(j, i)>0 f ′ ( i , j ) = a c ( i , j ) − g ( j , i ) > 0 ( i , j ) (i, j) ( i , j ) ( j , i ) (j, i) ( j , i ) ( j , i ) ∈ E f + g (j, i)\in E_{f+g} ( j , i ) ∈ E f + g
当 g ( j , i ) = a c ( j , i ) g(j, i)=ac(j, i) g ( j , i ) = a c ( j , i ) f ′ ( i , j ) = 0 f'(i, j)=0 f ′ ( i , j ) = 0 ( i , j ) (i, j) ( i , j ) ( j , i ) (j, i) ( j , i ) ( j , i ) ∉ E f + g (j, i)\notin E_{f+g} ( j , i ) ∈ / E f + g
此外,当 f ( i , j ) = c ( i , j ) f(i, j)=c(i, j) f ( i , j ) = c ( i , j ) f ′ ( i , j ) < c ( i , j ) f'(i, j)<c(i, j) f ′ ( i , j ) < c ( i , j ) N f + g N_{f+g} N f + g N f N_f N f ( i , j ) (i, j) ( i , j ) d ( i ) > d ( j ) d(i)>d(j) d ( i ) > d ( j ) A N f + g AN_{f+g} A N f + g
综上所述,A N f AN_f A N f N f + g N_{f+g} N f + g g g g
因为加上 g g g N f + g N_{f+g} N f + g A N f AN_f A N f A N f + g AN_{f+g} A N f + g N f N_f N f A N f AN_f A N f g g g N f + g N_{f+g} N f + g A N f AN_f A N f N f + g N_{f+g} N f + g A N f AN_f A N f
由 A N f + g AN_{f+g} A N f + g A N f + g AN_{f+g} A N f + g N f + g N_{f+g} N f + g
假设最短路径上的边全部由原本 A N f AN_f A N f g g g A N f AN_f A N f A N f AN_f A N f g g g A N f AN_f A N f
所以最短路径上至少有一条边不是原本 A N f AN_f A N f
因此,A N f + g AN_{f+g} A N f + g A N f AN_f A N f
定理 3 :Dinic 算法最终得到的 f f f O ( n 3 ) O(n^3) O ( n 3 )
证明:当算法终止时,A N f AN_f A N f s s s t t t A N f AN_f A N f N f N_f N f s s s t t t N f N_f N f v ( f ) = v ∗ v(f)=v^* v ( f ) = v ∗ f f f
由引理 7,每个阶段结束时,A N f AN_f A N f n − 1 n-1 n − 1 n − 1 n-1 n − 1
在每个阶段:
构造 A N f AN_f A N f O ( m ) O(m) O ( m )
计算顶点的流通量 —— O ( m ) O(m) O ( m )
找到流通量最小的顶点 —— O ( n ) O(n) O ( n ) O ( n ) O(n) O ( n ) O ( n 2 ) O(n^2) O ( n 2 )
从流通量最小的顶点向外推送流。
第一种情况是,推流之后变成饱和边,删去改变,最多有 O ( m ) O(m) O ( m )
第二种情况是,推流之后变成非饱和边,由于优先给容量较小的边,每次从某个顶点向外推送流时,至多产生一条非饱和边,故每次推流,最多有 O ( n ) O(n) O ( n ) n n n O ( n 2 ) O(n^2) O ( n 2 )
综上所述,每个阶段的时间复杂度为 O ( n 2 + m ) O(n^2 + m) O ( n 2 + m ) O ( n 3 + n m ) O(n^3 + nm) O ( n 3 + nm ) O ( n 3 ) O(n^3) O ( n 3 )
6.5、简单容量网络上的 Dinic 算法
边的容量均为 1,中间点或入度为一或出度为一的容量网络,称为简单容量网络 。
引理 8 :在简单容量网络中,s 到 t 的距离 l ⩽ n / v ∗ + 1 l\leqslant n/v^* +1 l ⩽ n / v ∗ + 1
证明:记到 s 的举例为 i i i V i , 1 ⩽ i ⩽ l − 1 V_i, 1\leqslant i \leqslant l-1 V i , 1 ⩽ i ⩽ l − 1 v ∗ ⩽ ∣ V i ∣ v^* \leqslant |V_i| v ∗ ⩽ ∣ V i ∣
( l − 1 ) v ∗ ⩽ ∑ i = 1 l − 1 ∣ V i ∣ ⩽ n (l-1)v^* \leqslant \sum_{i=1}^{l-1} |V_i| \leqslant n
( l − 1 ) v ∗ ⩽ i = 1 ∑ l − 1 ∣ V i ∣ ⩽ n
所以有 l ⩽ n / v ∗ + 1 l\leqslant n/v^* +1 l ⩽ n / v ∗ + 1
定理 4 :简单容量网络上,Dinic 算法在O ( n 1 / 2 m ) O(n^{1/2}m) O ( n 1/2 m )
7、最大流的应用
7.1、不相交路径问题
Edge Disjoint Paths,不相交路径 。有向图上,对于给定的两个顶点,如果这两个顶点之间的两条路径没有公共边,就称这两条路径是不相交的 。对于给定的两个顶点,求可以同时存在的不相交路径的最大条数。
考虑将给定的两个顶点看作源点和汇点,所有边的容量都设为 1(保证只能有 1 个单位的流流过,也即只能走一次。在这样的容量网络上求最大流,最大流的流量即为答案。
对于由多个起点和多个终点的不相交路径问题。考虑额外引入一个超级源点和一个超级汇点,超级源点到每个起点连一条容量无限的边,每个终点到超级汇点也连一条容量无限的的边。在这样的容量网络上求最大流,就可以得出结果了。
7.2、顶点存在容量限制的最大流
假设顶点也有容量,表示最多有多少流量能够流入 该节点。
假设顶点v v v c ( v ) c(v) c ( v ) v ′ v' v ′ v v v v ′ v' v ′ c ( v ) c(v) c ( v ) v v v v ′ v' v ′
在新网络上求解出最大流之后,将 v v v v ′ v' v ′
7.3、独立路径问题
起点和终点相同的两条路径,如果其没有其他的公共顶点,就称这两条路径是独立的 。对于给定的起点和终点,求可以同时存在的独立路径的最大条数。
给所有的中间点设置 1 的顶点容量限制。由 7.2 的方法,转化为普通最大流问题求解即可。
8、Floyd-Warshall 算法
也常简称为 Floyd 算法,这是一种在带负权边的图上求最短路径和检测负回路的算法
带权有向图D = ( V , E , w ) D=(V, E, w) D = ( V , E , w ) w : E → R w: E\rightarrow R w : E → R D D D 负回路 。
D D D D D D
记d ( k ) ( i , j ) d^{(k)}(i, j) d ( k ) ( i , j ) i i i j j j { 1 , 2 , … , k } \{1, 2, \dots, k\} { 1 , 2 , … , k }
d ( k ) ( i , j ) = { w ( i , j ) , k = 0 min { d ( k − 1 ) ( i , j ) , d ( k − 1 ) ( i , k ) + d ( k − 1 ) ( k , j ) } , 1 ⩽ k ⩽ n , 1 ⩽ i , j ⩽ n , i ≠ k , j ≠ k d^{(k)}(i, j)=\begin{cases}
w(i, j), & k=0\\
\min\{d^{(k-1)}(i, j), d^{(k-1)}(i, k)+d^{(k-1)}(k, j)\}, & 1\leqslant k\leqslant n, 1\leqslant i, j\leqslant n, i\neq k, j\neq k
\end{cases}
d ( k ) ( i , j ) = { w ( i , j ) , min { d ( k − 1 ) ( i , j ) , d ( k − 1 ) ( i , k ) + d ( k − 1 ) ( k , j )} , k = 0 1 ⩽ k ⩽ n , 1 ⩽ i , j ⩽ n , i = k , j = k
规定w ( i , i ) = 0 w(i, i)=0 w ( i , i ) = 0 ( i , j ) ∉ E (i, j)\notin E ( i , j ) ∈ / E w ( i , j ) = + ∞ w(i, j)=+\infin w ( i , j ) = + ∞
若D D D i i i i i i k k k d ( k ) ( i , i ) < 0 d^{(k)}(i, i)<0 d ( k ) ( i , i ) < 0
Floyd-Warshall 算法的时间复杂度为O ( n 3 ) O(n^3) O ( n 3 )
9、最小费用流
9.1、定义
在容量网络N = ( V , E , c , s , t ) N=(V, E, c, s, t) N = ( V , E , c , s , t ) w : E → R w: E\rightarrow R w : E → R 容量-费用网络 N = ( V , E , c , w , s , t ) N=(V, E, c, w, s, t) N = ( V , E , c , w , s , t )
设f f f N N N w ( f ) = ∑ ( i , j ) ∈ E w ( i , j ) f ( i , j ) w(f)=\sum_{(i, j)\in E} w(i, j)f(i, j) w ( f ) = ∑ ( i , j ) ∈ E w ( i , j ) f ( i , j ) f f f 费用 。所有流量为v v v v v v 最小费用流 。
最小费用流问题 就是,在容量-费用网络N N N v 0 v_0 v 0
容量-费用网络上也可以定义关于可行流f f f N f = ( V , E f , a c , a w , s , t ) N_f=(V, E_f, ac, aw, s, t) N f = ( V , E f , a c , a w , s , t ) E f E_f E f a c ac a c 辅助费用 的定义如下:
a w ( i , j ) = { w ( i , j ) , ( i , j ) ∈ E f + − w ( j , i ) , ( i , j ) ∈ E f − aw(i, j)=\begin{cases}
w(i, j), & (i, j)\in E_f^+\\
-w(j, i), & (i, j)\in E_f^-
\end{cases}
a w ( i , j ) = { w ( i , j ) , − w ( j , i ) , ( i , j ) ∈ E f + ( i , j ) ∈ E f −
也有类似的引理 9 :设f f f N N N g g g N f N_f N f f ′ = f + g f'=f+g f ′ = f + g N N N w ( f ′ ) = w ( f ) + a w ( g ) w(f')=w(f)+aw(g) w ( f ′ ) = w ( f ) + a w ( g )
9.2、圈流
设C C C N N N E C E_C E C C C C C C C 圈流 h C h^C h C
h C ( i , j ) = { δ , ( i , j ) ∈ E C 0 , o t h e r w i s e h^C(i, j)=\begin{cases}
\delta, & (i, j)\in E_C\\
0, & otherwise
\end{cases}
h C ( i , j ) = { δ , 0 , ( i , j ) ∈ E C o t h er w i se
其中δ = min ( i , j ) ∈ E C c ( i , j ) > 0 \delta = \min_{(i, j)\in E_C} c(i, j)>0 δ = min ( i , j ) ∈ E C c ( i , j ) > 0 h C h^C h C 环流量 。
显然,圈流是可行流,且v ( h C ) = 0 , w ( h C ) = δ ∑ ( i , j ) ∈ E C w ( i , j ) v(h^C)=0, w(h^C)=\delta\sum_{(i, j)\in E_C} w(i, j) v ( h C ) = 0 , w ( h C ) = δ ∑ ( i , j ) ∈ E C w ( i , j ) w ( C ) = ∑ ( i , j ) ∈ E C w ( i , j ) w(C)=\sum_{(i, j)\in E_C} w(i, j) w ( C ) = ∑ ( i , j ) ∈ E C w ( i , j ) a w ( C ) aw(C) a w ( C )
设f f f N N N f ′ = f + h C f'=f+h^C f ′ = f + h C v ( f ′ ) = v ( f ) , w ( f ′ ) = w ( f ) + δ ⋅ a w ( C ) v(f')=v(f), w(f')=w(f)+\delta\cdot aw(C) v ( f ′ ) = v ( f ) , w ( f ′ ) = w ( f ) + δ ⋅ a w ( C )
可以这样求最小费用流:首先求一个流量为v 0 v_0 v 0 N f N_f N f a w ( C ) < 0 aw(C)<0 a w ( C ) < 0 C C C f ′ ← f + h C f'\leftarrow f+h^C f ′ ← f + h C N f N_f N f
例如,对下面这个容量-费用网络,构建出辅助网络之后,可以找到一个圈流。可以确定 δ = 3 \delta=3 δ = 3
9.3、最小费用流的负回路算法
设 f 1 , f 2 f_1, f_2 f 1 , f 2 N f 2 N_{f_2} N f 2 g = f 1 − f 2 g=f_1-f_2 g = f 1 − f 2 ∀ ( i , j ) ∈ E \forall (i, j)\in E ∀ ( i , j ) ∈ E
若 f 1 ( i , j ) < f 2 ( i , j ) f_1(i, j) < f_2(i, j) f 1 ( i , j ) < f 2 ( i , j ) g ( i , j ) = f 2 ( i , j ) − f 1 ( i , j ) g(i, j) = f_2(i, j) - f_1(i, j) g ( i , j ) = f 2 ( i , j ) − f 1 ( i , j )
若 f 1 ( i , j ) > f 2 ( i , j ) f_1(i, j) > f_2(i, j) f 1 ( i , j ) > f 2 ( i , j ) g ( i , j ) = f 1 ( i , j ) − f 2 ( i , j ) g(i, j) = f_1(i, j) - f_2(i, j) g ( i , j ) = f 1 ( i , j ) − f 2 ( i , j )
N f 2 N_{f_2} N f 2 g g g
有引理 10 :设 f 1 , f 2 f_1, f_2 f 1 , f 2 g = f 1 − f 2 g=f_1-f_2 g = f 1 − f 2 g g g N f 2 N_{f_2} N f 2 f 1 = f 2 + g f_1=f_2+g f 1 = f 2 + g
可类似引理 5 进行证明。
引理 11 :若可行流 f f f v ( f ) = 0 v(f)=0 v ( f ) = 0 f f f
证明:记 E 1 = { ( i , j ) ∈ E ∣ f ( i , j ) > 0 } E_1=\{(i, j)\in E | f(i, j) > 0\} E 1 = {( i , j ) ∈ E ∣ f ( i , j ) > 0 } D 1 D_1 D 1 E 1 E_1 E 1 f f f E 1 ≠ ∅ E_1 \neq \emptyset E 1 = ∅
由于 f f f D 1 D_1 D 1 D 1 D_1 D 1 i i i D 1 D_1 D 1 i i i D 1 D_1 D 1 i i i ( i , k ) (i, k) ( i , k ) f ( i , k ) > 0 f(i, k)>0 f ( i , k ) > 0 i i i f f f i i i E 1 E_1 E 1 i i i i i i D 1 D_1 D 1 D 1 D_1 D 1
因为每个顶点的出度至少为 1,从任何一个顶点出发,沿着出边走下去,由于顶点数有限,一定会回到某个已经经过的顶点(鸽巢原理),从而形成一个回路,记这个回路为 C C C δ 1 = min { f ( i , j ) ∣ ( i , j ) ∈ E C } > 0 \delta_1=\min\{f(i, j)|(i, j)\in E_C\}>0 δ 1 = min { f ( i , j ) ∣ ( i , j ) ∈ E C } > 0 h C 1 h^{C_1} h C 1 C 1 C_1 C 1 δ 1 \delta_1 δ 1
令 f 1 = f − h C 1 f_1 = f-h^{C_1} f 1 = f − h C 1 f 1 f_1 f 1 v ( f 1 ) = 0 v(f_1)=0 v ( f 1 ) = 0 f 1 f_1 f 1 f f f f f f
定理 5 :设 f f f N N N v 0 v_0 v 0 f f f N f N_f N f a w aw a w
证明:之前已经说明了必要性,现证充分性。
假设 N f N_f N f a w aw a w f ′ f' f ′ N N N v 0 v_0 v 0 g = f ′ − f g=f'-f g = f ′ − f g g g N f N_f N f f ′ = f + g f'=f+g f ′ = f + g v ( f ′ ) = v ( f ) v(f')=v(f) v ( f ′ ) = v ( f ) v ( g ) = 0 v(g)=0 v ( g ) = 0
不妨设 f ′ ≠ f f'\neq f f ′ = f g g g g g g
g = h C 1 + h C 2 + ⋯ + h C k g=h^{C_1}+h^{C_2}+\dots+h^{C_k}
g = h C 1 + h C 2 + ⋯ + h C k
所以 g g g
a w ( g ) = δ 1 a w ( C 1 ) + δ 2 a w ( C 2 ) + ⋯ + δ k a w ( C k ) aw(g)=\delta_1 aw(C_1)+\delta_2 aw(C_2)+\dots+\delta_k aw(C_k)
a w ( g ) = δ 1 a w ( C 1 ) + δ 2 a w ( C 2 ) + ⋯ + δ k a w ( C k )
其中由 δ i > 0 \delta_i>0 δ i > 0 N f N_f N f ∀ i , a w ( C i ) ⩾ 0 \forall i, aw(C_i)\geqslant 0 ∀ i , a w ( C i ) ⩾ 0 a w ( g ) ⩾ 0 aw(g)\geqslant 0 a w ( g ) ⩾ 0 w ( f ′ ) = w ( f ) + a w ( g ) ⩾ w ( f ) w(f')=w(f)+aw(g)\geqslant w(f) w ( f ′ ) = w ( f ) + a w ( g ) ⩾ w ( f ) f f f
最小费用流的负回路的完整算法叙述如下:
调用最大流算法。若求出的最大流流量小于v 0 v_0 v 0
构造N f N_f N f
用 Floyd 算法检测N f N_f N f a w aw a w f f f
令 δ = min { a c ( i , j ) ∣ ( i , j ) ∈ E C } \delta=\min\{ac(i, j)|(i, j)\in E_C\} δ = min { a c ( i , j ) ∣ ( i , j ) ∈ E C } { f ( i , j ) ← f ( i , j ) + δ , ( i , j ) ∈ E C f ( j , i ) ← f ( j , i ) − δ , ( j , i ) ∈ E C \begin{cases}
f(i, j)\leftarrow f(i, j)+\delta, & (i, j)\in E_C\\
f(j, i)\leftarrow f(j, i)-\delta, & (j, i)\in E_C
\end{cases}
{ f ( i , j ) ← f ( i , j ) + δ , f ( j , i ) ← f ( j , i ) − δ , ( i , j ) ∈ E C ( j , i ) ∈ E C
然后回到步骤 2
9.4、最小费用流的最短路径算法
另一种求最小费用流的思路是,从一个某个费用最小的初始流f f f v ( f ) < v 0 v(f)<v_0 v ( f ) < v 0 P P P f ′ f' f ′ v 0 v_0 v 0 f ′ f' f ′
引理 12 :设有向图 D = ( V , E ) D=(V, E) D = ( V , E ) s s s t t t D D D
证明:从 s s s s , t s, t s , t t t t
删去 P 涉及的边,此时可能出现一些孤立点,再把这些孤立点删去。则剩下的顶点,入度都等于出度且不为 0,它们由若干条回路组成。证毕。
定理 6 :设 f f f N N N v 0 v_0 v 0 P P P N f N_f N f s s s t t t a w aw a w g g g P P P θ \theta θ f ′ = f + g f'=f+g f ′ = f + g N N N v 0 + θ v_0+\theta v 0 + θ
证明:假设 f ′ f' f ′ N f ′ N_{f'} N f ′ a w aw a w C C C
由于 f ′ f' f ′ f f f P P P N f N_f N f N f ′ N_{f'} N f ′ P P P ( i , j ) ∈ N f ′ − N f (i, j)\in N_{f'}-N_f ( i , j ) ∈ N f ′ − N f ( j , i ) ∈ E P (j, i)\in E_P ( j , i ) ∈ E P
因为 f f f N f N_f N f a w aw a w C C C N f N_f N f ( i 1 , j 1 ) , ( i 2 , j 2 ) , … , ( i r , j r ) (i_1, j_1), (i_2, j_2), \dots, (i_r, j_r) ( i 1 , j 1 ) , ( i 2 , j 2 ) , … , ( i r , j r ) ( j 1 , i 1 ) , ( j 2 , i 2 ) , … , ( j r , i r ) (j_1, i_1), (j_2, i_2), \dots, (j_r, i_r) ( j 1 , i 1 ) , ( j 2 , i 2 ) , … , ( j r , i r ) P P P 2 r 2r 2 r H H H
从 P P P C C C H H H P P P C C C D D D D D D s s s t t t P ′ P' P ′ C 1 , C 2 , … , C l C_1, C_2, \dots, C_l C 1 , C 2 , … , C l
于是有:
a w ( D ) = a w ( P ′ ) + a w ( C 1 ) + a w ( C 2 ) + ⋯ + a w ( C l ) aw(D)=aw(P')+aw(C_1)+aw(C_2)+\dots+aw(C_l)
a w ( D ) = a w ( P ′ ) + a w ( C 1 ) + a w ( C 2 ) + ⋯ + a w ( C l )
因为 a w ( H ) = 0 aw(H)=0 a w ( H ) = 0
a w ( P ) + a w ( C ) = a w ( D ) + a w ( H ) = a w ( P ′ ) + a w ( C 1 ) + a w ( C 2 ) + ⋯ + a w ( C l ) aw(P)+aw(C)=aw(D)+aw(H)=aw(P')+aw(C_1)+aw(C_2)+\dots+aw(C_l)
a w ( P ) + a w ( C ) = a w ( D ) + a w ( H ) = a w ( P ′ ) + a w ( C 1 ) + a w ( C 2 ) + ⋯ + a w ( C l )
所以有:
a w ( P ′ ) = a w ( P ) + a w ( C ) − [ a w ( C 1 ) + a w ( C 2 ) + ⋯ + a w ( C l ) ] aw(P')=aw(P)+aw(C)-[aw(C_1)+aw(C_2)+\dots+aw(C_l)]
a w ( P ′ ) = a w ( P ) + a w ( C ) − [ a w ( C 1 ) + a w ( C 2 ) + ⋯ + a w ( C l )]
由于 C 1 , C 2 , … , C l C_1, C_2, \dots, C_l C 1 , C 2 , … , C l N f N_f N f f f f a w ( C i ) ⩾ 0 , 1 ⩽ i ⩽ l aw(C_i)\geqslant 0, 1\leqslant i \leqslant l a w ( C i ) ⩾ 0 , 1 ⩽ i ⩽ l a w ( C ) < 0 aw(C)<0 a w ( C ) < 0 a w ( P ′ ) < a w ( P ) aw(P')<aw(P) a w ( P ′ ) < a w ( P ) P P P N f N_f N f a w aw a w
最小费用流的最短路径算法的完整叙述如下:
初始化零流f f f v = 0 v=0 v = 0
构造N f N_f N f
调用 Floyd 算法,计算N f N_f N f s s s t t t a w aw a w P P P
令 θ = min { v , min { a c ( i , j ) ∣ ( i , j ) ∈ E P } } \theta=\min\{v, \min\{ac(i, j)|(i, j)\in E_P\}\} θ = min { v , min { a c ( i , j ) ∣ ( i , j ) ∈ E P }} E P E_P E P ( i , j ) (i, j) ( i , j ) { f ( i , j ) ← f ( i , j ) + θ , ( i , j ) ∈ E f ( j , i ) ← f ( j , i ) − θ , ( j , i ) ∈ E \begin{cases}
f(i, j)\leftarrow f(i, j)+\theta, & (i, j)\in E\\
f(j, i)\leftarrow f(j, i)-\theta, & (j, i)\in E
\end{cases}
{ f ( i , j ) ← f ( i , j ) + θ , f ( j , i ) ← f ( j , i ) − θ , ( i , j ) ∈ E ( j , i ) ∈ E
令v ← v + θ v\leftarrow v+\theta v ← v + θ v ⩾ v 0 v\geqslant v_0 v ⩾ v 0
10、运输问题
10.1、问题定义与建模
有 m m m A 1 , A 2 , … , A m A_1, A_2, \dots, A_m A 1 , A 2 , … , A m a i a_i a i n n n B 1 , B 2 , … , B n B_1, B_2, \dots, B_n B 1 , B 2 , … , B n b j b_j b j
已知从产地 A i A_i A i B j B_j B j w i , j w_{i,j} w i , j
事实上,以上问题描述蕴含了一个产销平衡的假设,也即:
∑ i = 1 m a i = ∑ j = 1 n b j \sum_{i=1}^m a_i = \sum_{j=1}^n b_j
i = 1 ∑ m a i = j = 1 ∑ n b j
若产大于销,可以引入虚拟销地,需求量 b n + 1 = ∑ i = 1 m a i − ∑ j = 1 n b j b_{n+1} = \sum_{i=1}^m a_i - \sum_{j=1}^n b_j b n + 1 = ∑ i = 1 m a i − ∑ j = 1 n b j w ( i , n + 1 ) = 0 w(i, n+1) = 0 w ( i , n + 1 ) = 0 b n + 1 b_{n+1} b n + 1
若销大于产,可以引入虚拟产地,产量 a m + 1 = ∑ j = 1 n b j − ∑ i = 1 m a i a_{m+1} = \sum_{j=1}^n b_j - \sum_{i=1}^m a_i a m + 1 = ∑ j = 1 n b j − ∑ i = 1 m a i w ( m + 1 , j ) = 0 w(m+1, j) = 0 w ( m + 1 , j ) = 0 a m + 1 a_{m+1} a m + 1
因此我们总是可以假设 ∑ i = 1 m a i = ∑ j = 1 n b j \sum_{i=1}^m a_i = \sum_{j=1}^n b_j ∑ i = 1 m a i = ∑ j = 1 n b j
运输问题可以看作一个最小费用流问题。构造一个容量-费用网络 N = ( V , E , c , w , s , t ) N=(V, E, c, w, s, t) N = ( V , E , c , w , s , t )
V = { s , t } ∪ { A 1 , A 2 , … , A m } ∪ { B 1 , B 2 , … , B n } V=\{s, t\}\cup \{A_1, A_2, \dots, A_m\} \cup \{B_1, B_2, \dots, B_n\} V = { s , t } ∪ { A 1 , A 2 , … , A m } ∪ { B 1 , B 2 , … , B n } E = { ( s , A i ) ∣ 1 ⩽ i ⩽ m } ∪ { ( A i , B j ) ∣ 1 ⩽ i ⩽ m , 1 ⩽ j ⩽ n } ∪ { ( B j , t ) ∣ 1 ⩽ j ⩽ n } E=\{(s, A_i)|1\leqslant i \leqslant m\} \cup \{(A_i, B_j)|1\leqslant i \leqslant m, 1\leqslant j \leqslant n\} \cup \{(B_j, t)|1\leqslant j \leqslant n\} E = {( s , A i ) ∣1 ⩽ i ⩽ m } ∪ {( A i , B j ) ∣1 ⩽ i ⩽ m , 1 ⩽ j ⩽ n } ∪ {( B j , t ) ∣1 ⩽ j ⩽ n } c ( s , A i ) = a i , c ( A i , B j ) = + ∞ , c ( B j , t ) = b j c(s, A_i)=a_i, c(A_i, B_j)=+\infin, c(B_j, t)=b_j c ( s , A i ) = a i , c ( A i , B j ) = + ∞ , c ( B j , t ) = b j w ( s , A i ) = 0 , w ( A i , B j ) = w i , j , w ( B j , t ) = 0 w(s, A_i)=0, w(A_i, B_j)=w_{i, j}, w(B_j, t)=0 w ( s , A i ) = 0 , w ( A i , B j ) = w i , j , w ( B j , t ) = 0
流量为 v 0 = ∑ i = 1 m a i v_0=\sum_{i=1}^m a_i v 0 = ∑ i = 1 m a i v 0 v_0 v 0
首先,要确认一个初始方案,然后按照最小费用流的负回路算法或最短路径算法进行改进,直到得到最优解为止。
10.2、确认初始方案
作赋权的完全二部图 G = ( A , B , E , w ) G=(A, B, E, w) G = ( A , B , E , w )
A = { A 1 , A 2 , … , A m } A=\{A_1, A_2, \dots, A_m\} A = { A 1 , A 2 , … , A m } B = { B 1 , B 2 , … , B n } B=\{B_1, B_2, \dots, B_n\} B = { B 1 , B 2 , … , B n } E = { ( A i , B j ) ∣ 1 ⩽ i ⩽ m , 1 ⩽ j ⩽ n } E=\{(A_i, B_j)|1\leqslant i \leqslant m, 1\leqslant j \leqslant n\} E = {( A i , B j ) ∣1 ⩽ i ⩽ m , 1 ⩽ j ⩽ n } w : E → R w: E\rightarrow R w : E → R
如果:
{ ∑ j = 1 n x i , j = a i , 1 ⩽ i ⩽ m ∑ i = 1 m x i , j = b j , 1 ⩽ j ⩽ n x i , j ⩾ 0 , 1 ⩽ i ⩽ m , 1 ⩽ j ⩽ n \begin{cases}
& \sum_{j=1}^n x_{i, j} = a_i, & 1\leqslant i \leqslant m\\
& \sum_{i=1}^m x_{i, j} = b_j, & 1\leqslant j \leqslant n\\
& x_{i, j} \geqslant 0, & 1\leqslant i \leqslant m, 1\leqslant j \leqslant n
\end{cases}
⎩ ⎨ ⎧ ∑ j = 1 n x i , j = a i , ∑ i = 1 m x i , j = b j , x i , j ⩾ 0 , 1 ⩽ i ⩽ m 1 ⩽ j ⩽ n 1 ⩽ i ⩽ m , 1 ⩽ j ⩽ n
则 x = { x i , j } x=\{x_{i, j}\} x = { x i , j } G G G 调运方案 。调运方案的总费用为:
w ( x ) = ∑ i = 1 m ∑ j = 1 n w i , j x i , j w(x)=\sum_{i=1}^m \sum_{j=1}^n w_{i, j} x_{i, j}
w ( x ) = i = 1 ∑ m j = 1 ∑ n w i , j x i , j
运输问题也可以表述为求使 w ( x ) w(x) w ( x )
按照以下方法确定初始调运方案:
随意选取一条边 ( A i , B j ) (A_i, B_j) ( A i , B j ) x i , j = min { a i , b j } x_{i, j} = \min\{a_i, b_j\} x i , j = min { a i , b j }
如果 a i < b j a_i < b_j a i < b j A i A_i A i b j ← b j − a i b_j \leftarrow b_j - a_i b j ← b j − a i
如果 a i > b j a_i > b_j a i > b j B j B_j B j a i ← a i − b j a_i \leftarrow a_i - b_j a i ← a i − b j
如果 a i = b j a_i = b_j a i = b j A i A_i A i B j B_j B j ( A i , B k ) , k ≠ j (A_i, B_k), k\neq j ( A i , B k ) , k = j x i , k = 0 x_{i, k}=0 x i , k = 0 A i A_i A i B j B_j B j
重复步骤 1,直到选取了 m + n − 2 m+n-2 m + n − 2 A p A_p A p B q B_q B q ( A p , B q ) (A_p, B_q) ( A p , B q ) a p = b q a_p=b_q a p = b q ( A p , B q ) (A_p, B_q) ( A p , B q ) x p , q = a p x_{p, q} = a_p x p , q = a p m + n − 1 m+n-1 m + n − 1 选中边集 ,再令除选中边集之外的所有边的 x x x x = { x i , j } x=\{x_{i, j}\} x = { x i , j }
有命题:按以上方式确定的初始调运方案,选中边集 T T T G G G
证明:T T T m + n − 1 m+n-1 m + n − 1 m + n m+n m + n T T T T T T T T T
m + n = 2 m+n=2 m + n = 2 m = n = 1 m=n=1 m = n = 1 m + n = k ( k ⩽ 2 ) m+n=k(k\leqslant 2) m + n = k ( k ⩽ 2 )
现考虑 m + n = k + 1 m+n=k+1 m + n = k + 1 ( A i , B j ) (A_i, B_j) ( A i , B j ) a i < b j a_i<b_j a i < b j G G G A i A_i A i G ′ G' G ′ T T T A i A_i A i ( A i , B j ) (A_i, B_j) ( A i , B j ) T ′ T' T ′ G ′ G' G ′ k k k T ′ T' T ′ G ′ G' G ′ k − 1 k-1 k − 1 T ′ T' T ′ ( A i , B j ) (A_i, B_j) ( A i , B j ) A i A_i A i T ′ T' T ′ T T T a i > b j a_i>b_j a i > b j
若 a i = b j a_i=b_j a i = b j ( A i , B k ) , k ≠ j (A_i, B_k), k\neq j ( A i , B k ) , k = j A i A_i A i B j B_j B j G ′ G' G ′ T T T A i , B j A_i, B_j A i , B j ( A i , B j ) , ( A i , B k ) (A_i, B_j), (A_i, B_k) ( A i , B j ) , ( A i , B k ) T ′ T' T ′ G ′ G' G ′ k − 1 k-1 k − 1 T ′ T' T ′ G ′ G' G ′ k − 2 k-2 k − 2 T ′ T' T ′ ( A i , B j ) , ( A i , B k ) (A_i, B_j), (A_i, B_k) ( A i , B j ) , ( A i , B k ) A i , B j A_i, B_j A i , B j T ′ T' T ′ T T T
10.3、改进调运方案
设 T = { A i r , B j r ∣ 1 ⩽ r ⩽ m + n − 1 } T=\{A_{i_r}, B_{j_r}|1\leqslant r \leqslant m+n-1\} T = { A i r , B j r ∣1 ⩽ r ⩽ m + n − 1 } u i u_i u i A i A_i A i v j v_j v j B j B_j B j
对每一条选中的边,( A i r , B j r ) (A_{i_r}, B_{j_r}) ( A i r , B j r )
u i r + v j r = w i r , j r , 1 ⩽ r ⩽ m + n − 1 u_{i_r} + v_{j_r} = w_{i_r, j_r}, 1\leqslant r \leqslant m+n-1
u i r + v j r = w i r , j r , 1 ⩽ r ⩽ m + n − 1
联立起来,得到一个 m + n m+n m + n m + n − 1 m+n-1 m + n − 1 位势 。
记 λ i , j = w i , j − ( u i + v j ) \lambda_{i, j} = w_{i, j} - (u_i + v_j) λ i , j = w i , j − ( u i + v j ) ( A i , B j ) (A_i, B_j) ( A i , B j ) 检验数 。显然选中边的检验数均为 0。
调运方案 x x x N N N v 0 v_0 v 0 x x x s s s t t t N x N_x N x N x N_x N x C C C s s s t t t C C C G G G
由于 T T T G G G G G G ( A i , B j ) (A_i, B_j) ( A i , B j ) T T T P P P C i , j C_{i, j} C i , j i 0 = i , j 0 = j i_0=i, j_0=j i 0 = i , j 0 = j C i , j C_{i, j} C i , j C i , j = A i 0 B j 0 P = A i 0 B j 0 A i 1 B j 1 … B j p A i 0 C_{i, j}=A_{i_0}B_{j_0}P=A_{i_0}B_{j_0}A_{i_1}B_{j_1}\dots B_{j_p}A_{i_0} C i , j = A i 0 B j 0 P = A i 0 B j 0 A i 1 B j 1 … B j p A i 0
因为从 B B B A A A ( A i , B j ) (A_i, B_j) ( A i , B j ) C i , j C_{i, j} C i , j
w ( C i , j ) = w i 0 , j 0 − w i 1 , j 0 + w i 1 , j 1 − w i 2 , j 1 + ⋯ + w i p , j p − w i 0 , j p = w i 0 , j 0 − ( u i 1 + v j 0 ) + ( u i 1 + v j 1 ) − ( u i 2 + v j 1 ) + ⋯ + ( u i p + v j p ) − ( u i 0 + v j p ) = w i 0 , j 0 − ( u i 0 + v j 0 ) = λ i , j \begin{split}
w(C_{i, j})&=w_{i_0, j_0}-w_{i_1, j_0}+w_{i_1, j_1}-w_{i_2, j_1}+\dots + w_{i_p, j_p}-w_{i_0, j_p}\\
&=w_{i_0, j_0}-(u_{i_1}+v_{j_0})+(u_{i_1}+v_{j_1})-(u_{i_2}+v_{j_1})+\dots +(u_{i_p}+v_{j_p})-(u_{i_0}+v_{j_p})\\
&=w_{i_0, j_0}-(u_{i_0}+v_{j_0})=\lambda_{i, j}
\end{split}
w ( C i , j ) = w i 0 , j 0 − w i 1 , j 0 + w i 1 , j 1 − w i 2 , j 1 + ⋯ + w i p , j p − w i 0 , j p = w i 0 , j 0 − ( u i 1 + v j 0 ) + ( u i 1 + v j 1 ) − ( u i 2 + v j 1 ) + ⋯ + ( u i p + v j p ) − ( u i 0 + v j p ) = w i 0 , j 0 − ( u i 0 + v j 0 ) = λ i , j
也即 ( A i , B j ) (A_i, B_j) ( A i , B j )
视 ( A i , B j ) (A_i, B_j) ( A i , B j ) i 0 = i p + 1 − i , j 0 = j i_0=i_{p+1}-i, j_0=j i 0 = i p + 1 − i , j 0 = j
记调整量:
δ = min { x i r + 1 j r ∣ 0 ⩽ r ⩽ p } \delta = \min\{x_{i_{r+1}}j_r | 0\leqslant r \leqslant p\}
δ = min { x i r + 1 j r ∣0 ⩽ r ⩽ p }
也即回路中第偶数条边(都是反向边)的最小值。然后做如下调整:
x k l ′ = { x k l + δ , k = i r , l = j r x k l − δ , k = i r + 1 , l = j r x k l , o t h e r w i s e x_{kl}'=\begin{cases}
x_{kl}+\delta, & k=i_r, l=j_r\\
x_{kl}-\delta, & k=i_{r+1}, l=j_r\\
x_{kl}, & otherwise
\end{cases}
x k l ′ = ⎩ ⎨ ⎧ x k l + δ , x k l − δ , x k l , k = i r , l = j r k = i r + 1 , l = j r o t h er w i se
也即第奇数条边流量加 δ \delta δ δ \delta δ
设 e e e d e l t a delta d e lt a x x x x ′ x' x ′ e e e ( A i , B j ) (A_i, B_j) ( A i , B j ) e e e T ′ T' T ′
以上操作称之为选中边替换 ,( A i , B j ) (A_i, B_j) ( A i , B j ) 换入边 ,e e e 唤出边 。选中边替换,实际上就是找到检验数为负的非选中边,然后通过它所构成的回路调整流量,从而降低总费用。为了保持性质,用 ( A i , B j ) (A_i, B_j) ( A i , B j )
引理 13 :对调运方案 x x x T T T ( A i , B j ) (A_i, B_j) ( A i , B j ) x ′ x' x ′ T ′ T' T ′ x ′ x' x ′ w ( x ′ ) = w ( x ) + λ i , j ⋅ δ w(x')=w(x)+\lambda_{i, j}\cdot \delta w ( x ′ ) = w ( x ) + λ i , j ⋅ δ
定理 7 :一个调运方案时最优的当且仅当所有检验数均不小于 0。
证明:必要性由引理 13 易得。 现证充分性。
设所有的检验数均不小于 0。由定理 5,要证明调运方案最优,只需要证明 G G G w w w
由前述,所有的基本回路(加入一条非树边构成的回路)均不是负回路。若某个回路 C C C ( A i , B j ) (A_i, B_j) ( A i , B j ) C i , j = X 1 … A i B j … X 2 … Y … X 1 C_{i, j}=X_1 \dots A_iB_j\dots X_2\dots Y \dots X_1 C i , j = X 1 … A i B j … X 2 … Y … X 1 X 1 , X 2 X_1, X_2 X 1 , X 2 C C C C i , j C_{i, j} C i , j C = X 1 … A i B j … X 2 … Z … X 1 C = X_1 \dots A_iB_j \dots X_2 \dots Z \dots X_1 C = X 1 … A i B j … X 2 … Z … X 1
令 C ′ = X 2 … Z … X 1 … Y … X 2 C' = X_2 \dots Z \dots X_1\dots Y \dots X_2 C ′ = X 2 … Z … X 1 … Y … X 2 w ( C i , j ) + w ( C ′ ) = w ( C ) w(C_{i, j})+w(C')=w(C) w ( C i , j ) + w ( C ′ ) = w ( C ) C i , j C_{i, j} C i , j w ( C i , j ) ⩾ 0 w(C_{i, j})\geqslant 0 w ( C i , j ) ⩾ 0 w ( C ′ ) ⩽ w ( C ) w(C')\leqslant w(C) w ( C ′ ) ⩽ w ( C ) C ′ C' C ′ C C C
11、二部图匹配
11.1、定义
简单二部图是一个无向图G = ( A , B , E ) G=(A, B, E) G = ( A , B , E ) A , B A, B A , B ∀ ( i , j ) ∈ E , i ∈ A , j ∈ B \forall (i, j)\in E, i\in A, j\in B ∀ ( i , j ) ∈ E , i ∈ A , j ∈ B
如果存在一个边集M ⊂ E M\subset E M ⊂ E M M M M M M G G G 匹配 。边数最多的匹配称为最大匹配 。当∣ A ∣ = ∣ B ∣ = ∣ M ∣ |A|=|B|=|M| ∣ A ∣ = ∣ B ∣ = ∣ M ∣ M M M 完美匹配 。
二部图常用于对两种不同类型的对象进行配对的问题,例如任务分配问题(一个人可以完成某些任务,但是最多只能去完成一个任务,要求分配任务使得尽可能多的人得到任务)。
设M M M G G G M M M 匹配边 ,E − M E-M E − M 非匹配边 。与匹配边关联的顶点称为饱和点 ,不与任何一条匹配边关联的顶点称为未饱和点 。
G G G 交错路径 。如果交错路径的起点和终点都是未饱和点,则称这条交错路径是增广交错路径 。
引理:设M M M G G G P P P
M ′ = M ⊕ E P = M ∪ E P − M ∩ E P M'=M\oplus E_P=M\cup E_P-M\cap E_P
M ′ = M ⊕ E P = M ∪ E P − M ∩ E P
是一个匹配,且∣ M ′ ∣ = ∣ M ∣ + 1 |M'|=|M|+1 ∣ M ′ ∣ = ∣ M ∣ + 1 E P E_P E P P P P
例如对以下二部图和其一个匹配(线代表二部图,红线代表匹配):
则 P = A 1 B 1 A 2 B 2 A 3 B 4 P=A_1B_1A_2B_2A_3B_4 P = A 1 B 1 A 2 B 2 A 3 B 4
由引理易得定理:二部图的匹配是最大匹配当且仅当不存在关于它的增广交错路径。
11.2、匈牙利算法
由上述定理,可以得到匈牙利算法的基本思想:从初始匹配M M M P P P M ← M ⊕ E P M\leftarrow M\oplus E_P M ← M ⊕ E P
若( A i , B j ) ∈ M (A_i, B_j)\in M ( A i , B j ) ∈ M m a t c h ( A i ) = B j , m a t c h ( B j ) = A i match(A_i)=B_j, match(B_j)=A_i ma t c h ( A i ) = B j , ma t c h ( B j ) = A i A i A_i A i m a t c h ( A i ) = 0 match(A_i)=0 ma t c h ( A i ) = 0
匈牙利算法的完整叙述如下:
初始化匹配M = ∅ M=\emptyset M = ∅
记A A A X X X X = ∅ X=\emptyset X = ∅
对于A A A A i A_i A i l ( A i ) = 0 l(A_i)=0 l ( A i ) = 0 X X X
记B B B Y Y Y Y = B Y=B Y = B
当X X X X X X A i A_i A i Y Y Y A i A_i A i B j B_j B j B B B A i A_i A i B j B_j B j l ( B j ) = A i l(B_j)=A_i l ( B j ) = A i
如果B j B_j B j
如果B j B_j B j B j B_j B j A k A_k A k A k A_k A k X X X B j B_j B j l ( A k ) = B j l(A_k)=B_j l ( A k ) = B j
X X X M M M 令m a t c h ( A i ) = B j , m a t c h ( B j ) = A i match(A_i)=B_j, match(B_j)=A_i ma t c h ( A i ) = B j , ma t c h ( B j ) = A i
如果l ( A i ) = 0 l(A_i)=0 l ( A i ) = 0 B j ← l ( A i ) , A i ← l ( B j ) B_j\leftarrow l(A_i), A_i\leftarrow l(B_j) B j ← l ( A i ) , A i ← l ( B j )
定理:匈牙利算法终止时得到的匹配是G G G O ( min { ∣ A ∣ , ∣ E ∣ } ⋅ ∣ E ∣ ) O(\min\{|A|, |E|\}\cdot |E|) O ( min { ∣ A ∣ , ∣ E ∣ } ⋅ ∣ E ∣ )
11.3、最大匹配与最大流
二部图的最大匹配问题可以转化为最大流问题。
设G = ( A , B , E ) G=(A, B, E) G = ( A , B , E ) N G = ( V , E ′ , c , s , t ) N_G = (V, E', c, s, t) N G = ( V , E ′ , c , s , t )
V = A ∪ B ∪ { s , t } V = A \cup B \cup \{s, t\} V = A ∪ B ∪ { s , t } E ′ = { ( s , A i ) ∣ A i ∈ A } ∪ { ( A i , B j ) ∣ ( A i , B j ) ∈ E } ∪ { ( B j , t ) ∣ B j ∈ B } E' = \{(s, A_i) | A_i \in A\} \cup \{(A_i, B_j) | (A_i, B_j) \in E\} \cup \{(B_j, t) | B_j \in B\} E ′ = {( s , A i ) ∣ A i ∈ A } ∪ {( A i , B j ) ∣ ( A i , B j ) ∈ E } ∪ {( B j , t ) ∣ B j ∈ B } ∀ ( i , j ) ∈ E ′ , c ( i , j ) = 1 \forall (i, j) \in E', c(i, j) = 1 ∀ ( i , j ) ∈ E ′ , c ( i , j ) = 1
则 G G G N G N_G N G G G G N G N_G N G
容易发现,N G N_G N G O ( n 1 / 2 m ) O(n^{1/2}m) O ( n 1/2 m ) G G G